
【研究笔记08】从SOC估计开始:钠电BMS利用实验反馈继续改进
Brian · 发布于 2026/10/16 · 更新于 2026/10/16
Brian2026/10/16
参加「初焰·纳宙」AI for Science 黑客松,我选择的议题是:
储能系统能否持续自我改进?从钠电与磷酸铁锂的充放电差异出发,研究电池管理系统(BMS)如何利用运行数据改进策略、迭代模型与架构,探索递归自我改进(RSI)的可能。
项目链接:1836 项目页 · 实验 GitHub 仓库(私有仓库,需访问权限)。
在前面的研究笔记里我先整理了钠电、BMS 和递归自我改进的概念,接着从不同角度试图理解题目中的不同概念。这一次,我想把其中一个问题变成可以观察的实验:让 AI 看过一次失败的结果以后,它能否提出一个更合适的电池估计算法配置,并把有效结果留给下一轮?
为此,我把研究范围缩小到 BMS 的一个功能:估计剩余电量。本文依次说明这个功能在做什么、两种方法怎样比较,以及每张图能帮助我们判断什么。实验使用真实电芯的历史记录,在电脑上离线回放。
一、先认识研究对象:我们到底在改什么?
SOC(State of Charge,荷电状态)回答的是“电池现在还剩多少电量”。它不能像端电压那样由一个传感器直接读出,需要结合电流、电压、容量和模型来估计。例如,评分参考是 50%,程序估计为 52%,两者相差 2 个百分点,记作 2 pp。
这次使用的估计器,可以理解为两种信息的结合:一方面,根据流出的电流累计计算还剩多少电量;另一方面,根据电池模型预测端电压,再用实测电压与预测电压之间的偏差修正估计。实现这一过程的方法是扩展卡尔曼滤波(EKF)。电阻 R0 也会随每个采样点更新,帮助模型解释电压变化。自适应估计方法参考
Agent 本轮不能改写这套算法,只能调整其中两个“信任程度”的参数。
| 可调参数 | 通俗含义 | 改动可能带来什么 |
|---|---|---|
| 电压观测噪声尺度 σᵥ | 算法认为电压观测有多不可靠 | 调大通常会降低电压残差对更新的影响,但也可能错过有用校正 |
| SOC 过程噪声尺度 σₛ | 算法认为自身 SOC 预测有多不确定 | 调大可能让 SOC 更容易被观测修正,也可能带来更大波动或偏差 |
这两个参数不是“越大越好”或“越小越好”。它们要与电芯模型、输入误差和当前工况配合。例如,电压模型有偏差时,过分相信电压未必能把 SOC 修正得更准。
这里还要区分两个时间尺度:估计器在一段放电记录内部逐点更新 SOC 和 R0;研究流程则在整段回放结束后,才决定下一次用哪组参数。 前者是已经写好的自适应算法,后者才是本次比较常规搜索与 Agent 的部分。
二、实验输入:哪些来自电芯,哪些是人为构造的?
本轮使用公开数据集中的一颗商业钠离子电芯 MU49,采用其 25°C 条件记录。数据集与许可
一套估计器不能只拿到电压曲线就开始调参。首先要准备“这个电芯大致怎样工作”的模型,再选一段记录检查估计结果。
| 数据 | 在实验中做什么 | 可以怎样理解 |
|---|---|---|
| C/50 缓慢充放电 | 建立准 OCV–SOC 关系,并提供容量参考 | 电压与电量的近似对应表 |
| HPPC 电流脉冲 | 拟合一阶 RC 模型中的电阻和极化动态 | 电流突然变化时,电压怎样响应 |
| 约 56 分钟的 1C 放电 | 反复回放,对不同参数进行同条件评分 | 两种搜索方法面对的共同考题 |
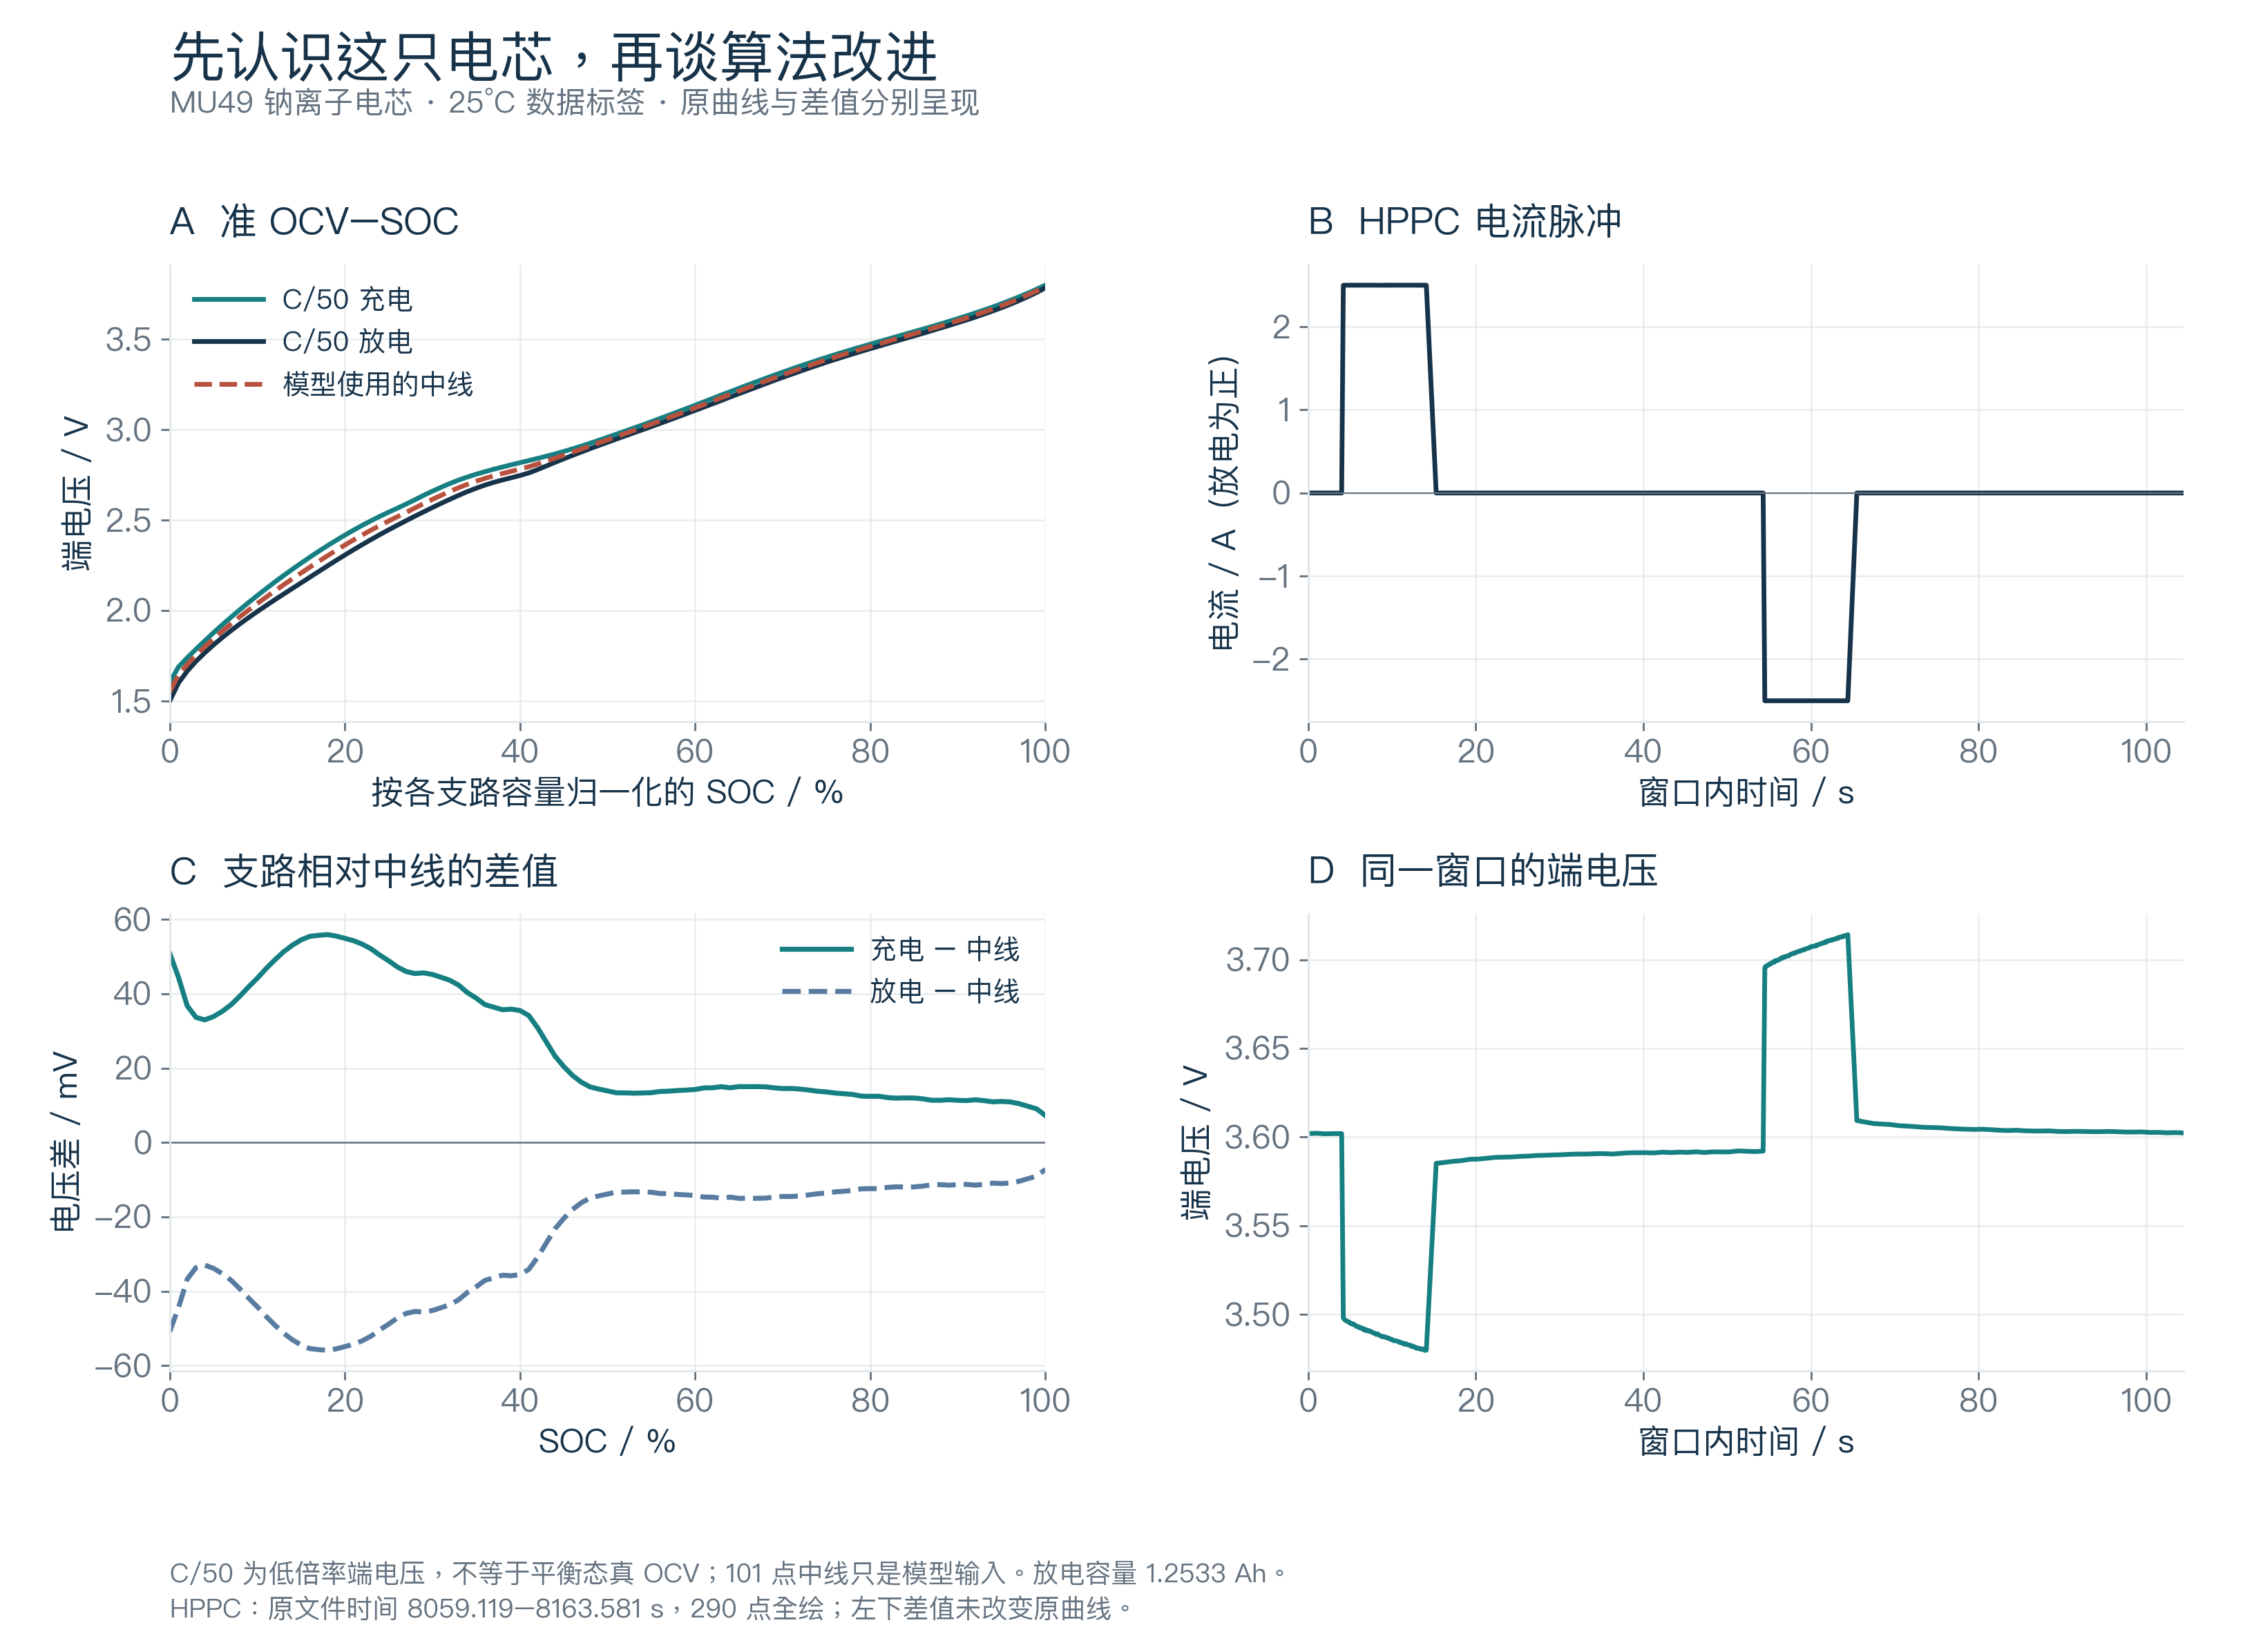
图1|原始电芯资料。A、C 是准 OCV 及其差值;B、D 是同一时间窗口中的 HPPC 电流与电压。图内字母只是子图编号。
先看左上 A 图。 充电、放电和模型中线很接近,尤其高 SOC 区间容易看成一条线。但左下 C 图把“支路减去中线”单独画出后,可以看到差别在部分 SOC 区间达到几十毫伏。
再对照右侧 B、D 图。 放电脉冲出现时,端电压迅速下降;电流回到零以后,电压又向上恢复。充电脉冲则呈相反方向。快速跳变和随后缓慢变化,为电阻与极化动态提供了辨识线索。但这解释了为什么使用脉冲数据建模。
接下来,我从同一颗电芯选取一段 1C 放电,共 3354 个采样点。这里的 1C 表示电流大小约等于额定容量对应的一小时放电电流。
为了考察测量与容量误差的影响,我把这段数据做成两个固定场景:容量设低场景使用 2 mV 电压噪声,并把算法使用的容量设为参考容量的 97%;容量设高场景使用 5 mV 电压噪声,容量设为 104%。两者还加入了不同的电流增益与零偏。每个候选都使用相同的扰动数组。这里的“容量设低/设高”指算法使用的容量假设,不代表换了两颗电芯;两种场景的电流误差和电压噪声也不同。
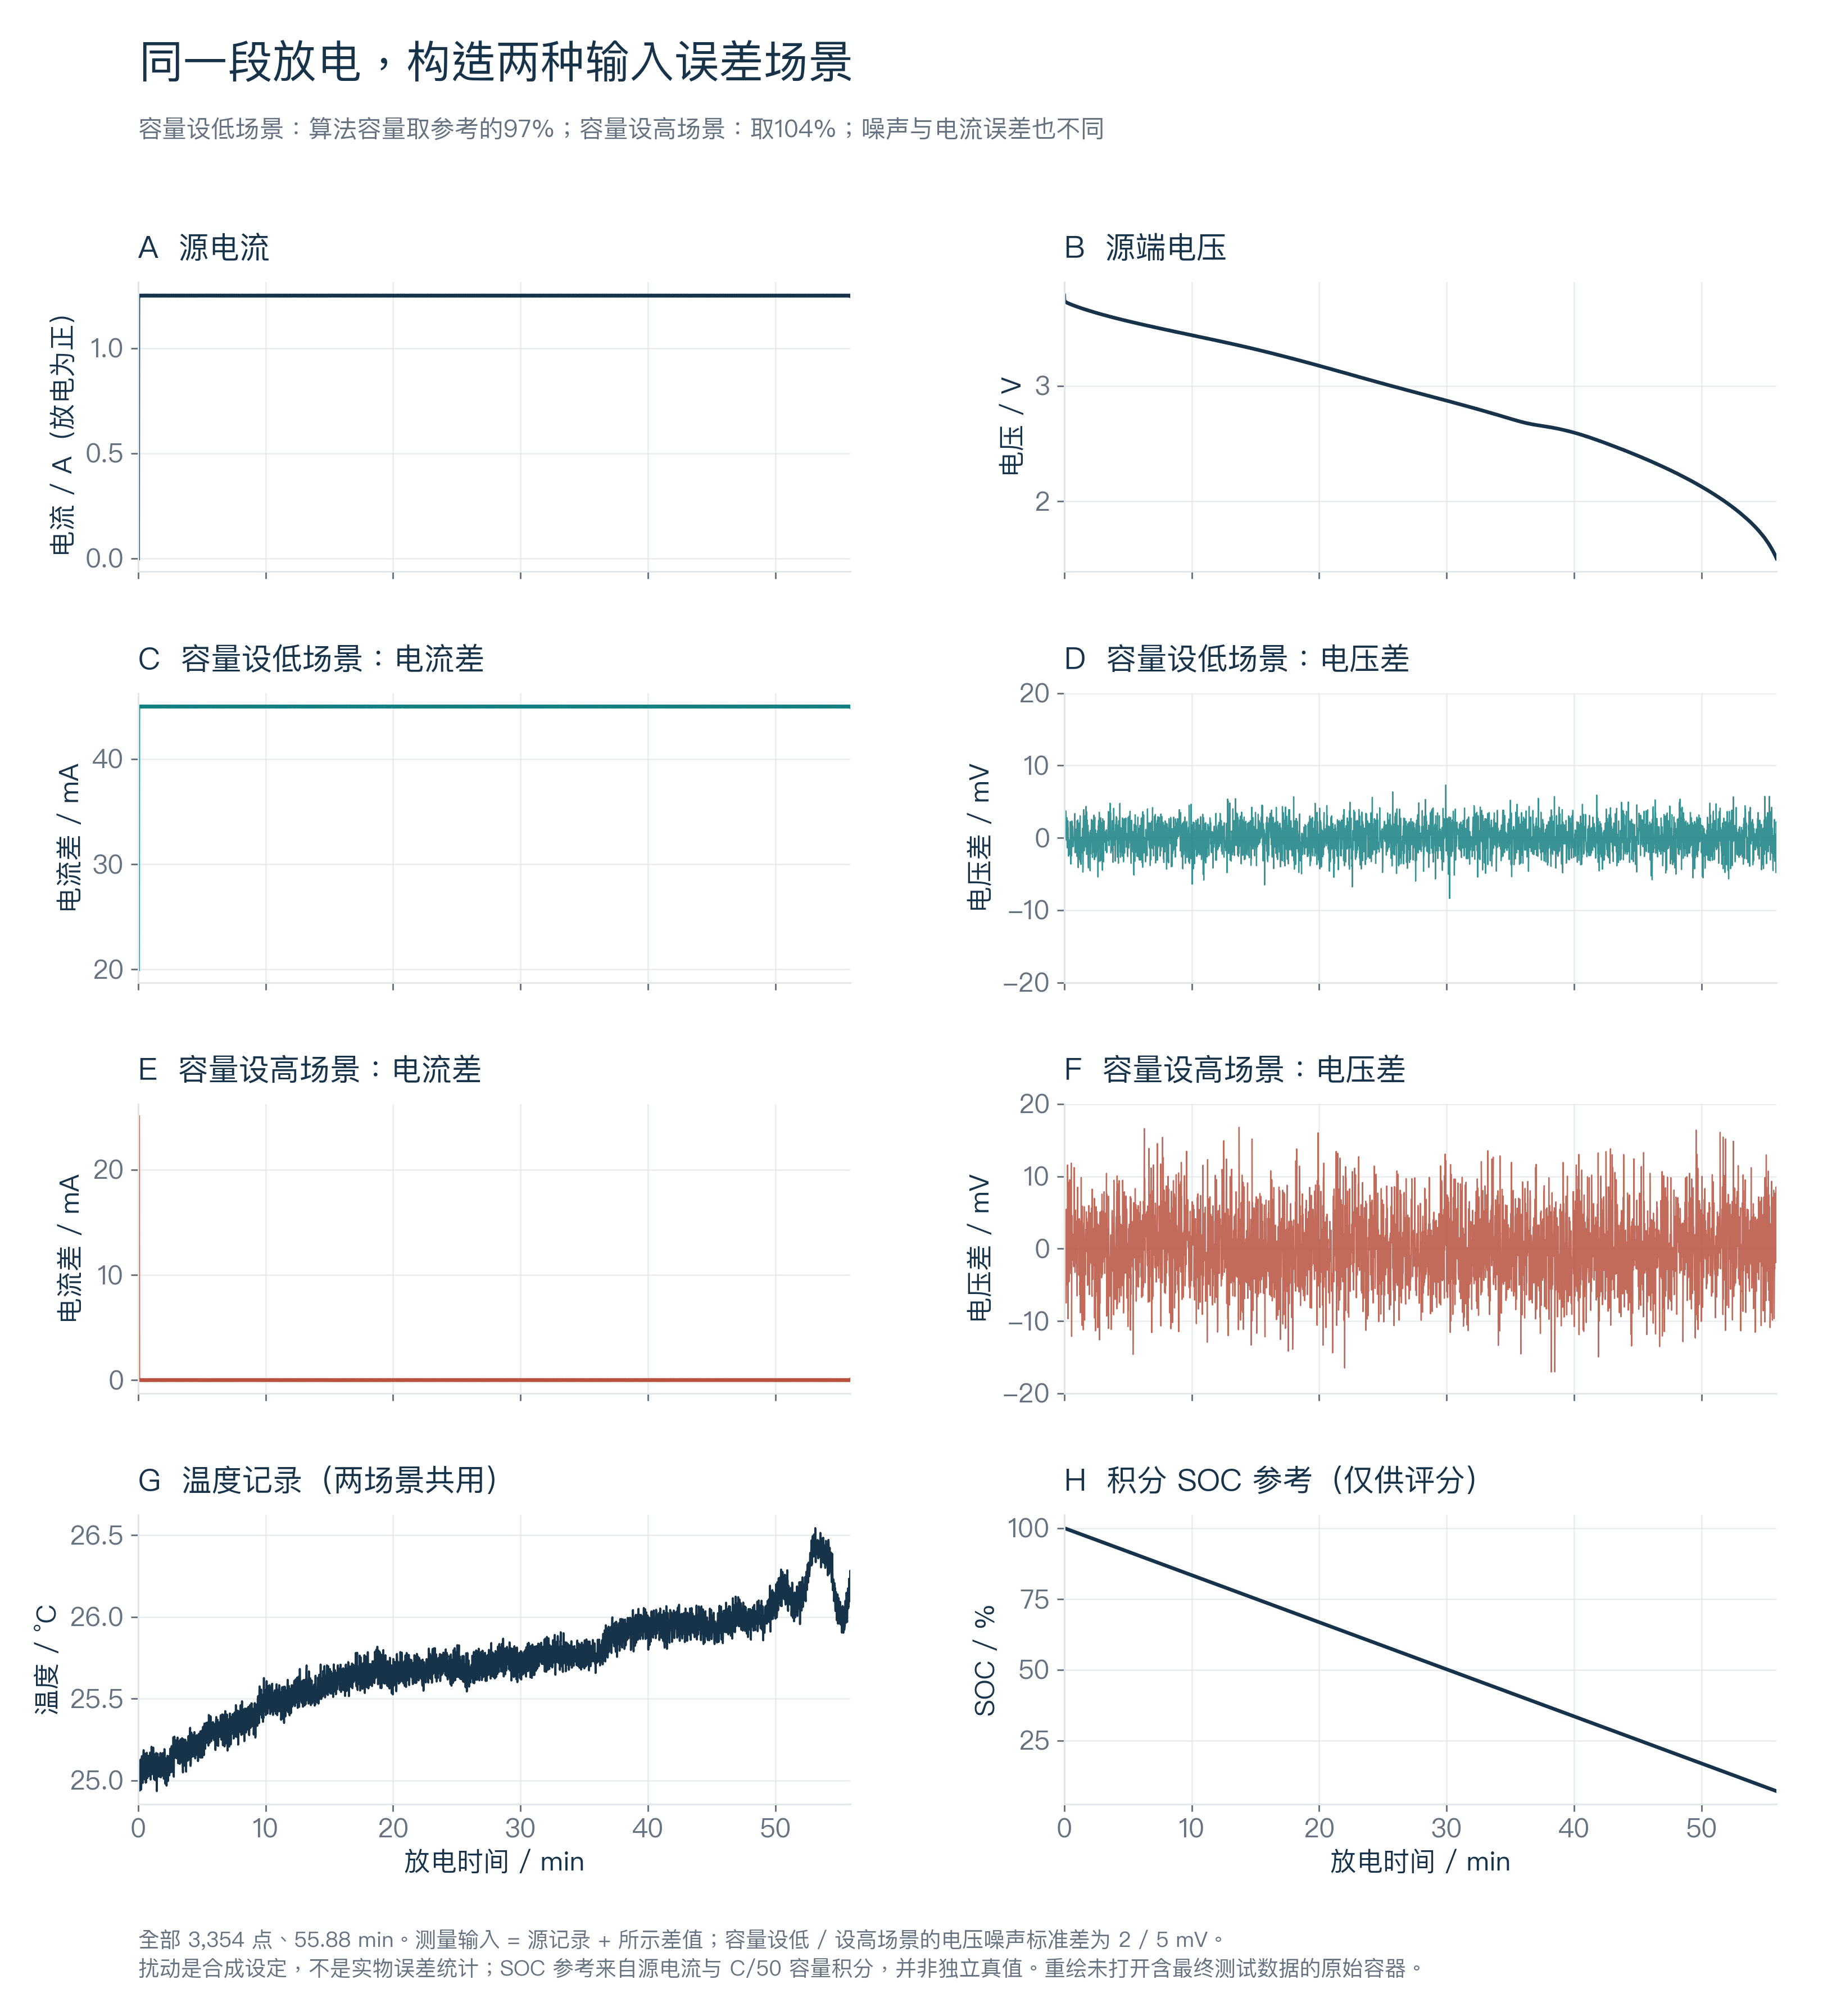
图2|A、B 为原始电流和电压;C—F 分别展示两个场景相对源记录的差值;G、H 为温度与积分 SOC 参考。所有面板保留完整时间窗。
图2上排显示,电流基本恒定,电压却在末段下降得更陡。 与此同时,右下 H 图的积分 SOC 参考近似线性下降。因此,不能把“电压下降更快”直接解释为“电量也按同样比例消耗得更快”。这正是 SOC 估计需要电芯关系曲线和动态模型的原因。
中间两排则解释了两个场景的差别。 容量设高场景的电压噪声带明显更宽,这是预设的 5 mV 与 2 mV 噪声尺度造成的;容量设低场景的电流在恒流主体段高出源记录约 45 mA,容量设高场景的增益与零偏在这一段接近抵消。它们给估计器带来了不同的偏差组合。
评分使用的 SOC 参考,是原始电流与源容量积分的结果,依赖初始满电假设。估计器获得的是扰动后的输入和容量假设。参考并非独立测得的真实 SOC,因此本轮比较的是相对于同一份构造参考,哪种配置的离线偏差更小。
三、对照怎么做:同一个估计器,两种调参方式
这一轮要比较的问题是:同一个 SOC 估计器,用固定规则寻找参数,还是让 Agent 根据历史实验结果提出参数,哪一种能找到更好的配置?
我先选定一套电阻能够在线更新的自适应 EKF,固定算法代码和初始参数。两组都从这份初始版出发,每组各有八次提出新参数的机会。
| 实验组 | 下一组参数怎样产生 | 每次提案之后做什么 |
|---|---|---|
| 规则调参组 | 程序按预定次序,轮流增大或减小两个参数;起始步长约为乘以或除以 1.26 | 回放数据、计算误差,由固定规则决定是否采用 |
| Agent 调参组 | 模型读取允许提供的历史参数和评价摘要,再提出一组新参数 | 使用相同的回放程序、指标和收录规则 |
两组的区别在于“怎样提出下一组参数”,而不是使用了不同的 SOC 算法。 规则调参组作为一个可复算的常规搜索对照,不代表所有业内最优调参方法。Agent 调参组使用接口标识为 Claude Opus 5.5 的服务,上游模型身份未独立认证。
前文的两种输入误差场景,是每个候选都要完成的两套考题。每提出一组有效参数,就分别回放这两个场景,再汇总评分;它们不是另外两组调参方法。两组共享电芯模型、数据、参数范围、初始配置和评分规则,但不读取对方的搜索结果。最终测试分区本轮未提取或评分。
结果图里还放了一套固定电阻 EKF,帮助观察电阻是否在线更新时的表现差别。它只提供参考,不参加这八轮搜索。这样,读图时只需先记住:初始版是起点,规则调参组和 Agent 调参组是两条探索路线。
读图约定:方法写组名,候选写“本组第几次提案”;“最终版”指本轮结束时采用的参数配置。图中 A、B、C 等字母只用于定位子图。
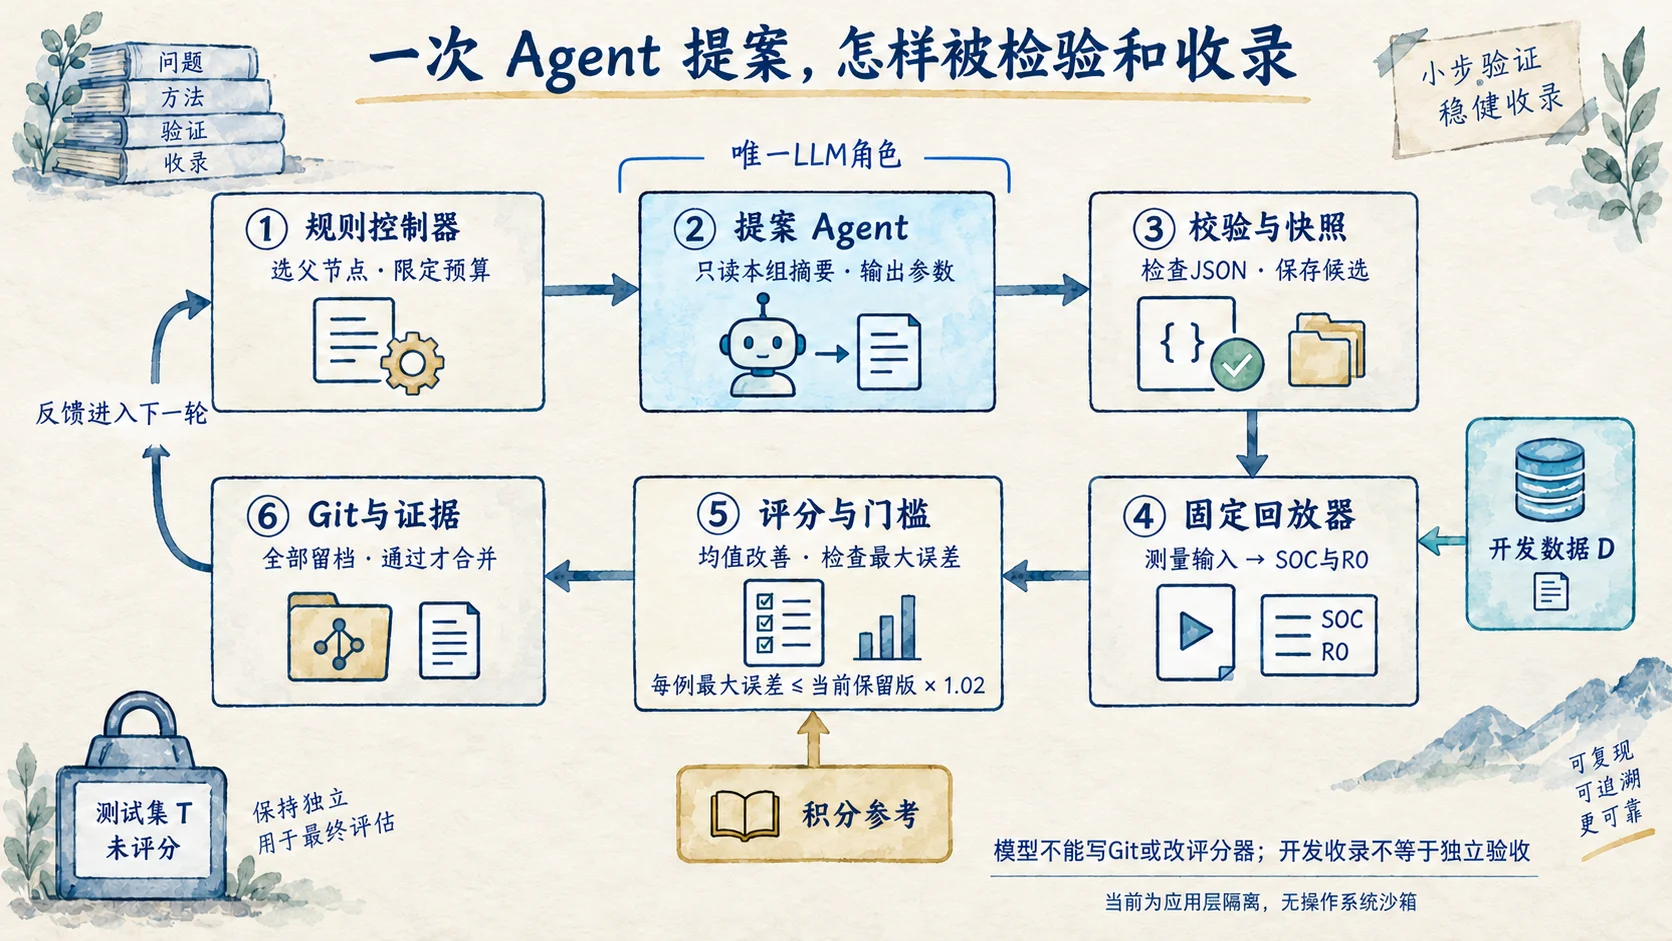
图3|单次实验的数据流程。图中 D 表示开发数据,T 表示尚未评分的最终测试分区。只有参数提案者调用大模型,其余方框由固定程序执行;开发反馈按允许范围返回下一轮。
沿图3的箭头看,一次尝试包含六个环节。 控制器先选择历史起点,把参数、规则和结果摘要交给提案者;提案者返回一组新参数;程序检查格式和范围;回放器用新参数分别跑完两个场景;评分器决定保留或拒绝,再由 Git 记录参数与结果。下一次提案能看到的是允许导出的摘要。
因此,这张图不是“几个 AI 商量以后投票通过”。模型负责提出建议,固定程序负责运行和判定。模型没有执行代码或操作 Git 的工具,也拿不到原始 SOC 参考序列。当前是应用层分工,尚不是操作系统级沙箱;可信准备器加载过包含最终测试分区的原始 MAT 容器。
怎样判定一次尝试成功?
我使用两层规则。先检查整段轨迹的数值是否合理:电阻处于规定范围,SOC 越界受限,协方差和数值正常。通过以后,再和该组当前保留版比较:两个场景平均的时间加权 SOC 均方根误差(RMSE)必须下降,同时每个场景的最大绝对误差最多增加 2%。
RMSE 越小,说明整段偏差总体更小;最大绝对误差则看整段里最差的一刻。两者一起使用,是为了避免平均表现变好,却在某个时刻明显失准。主要评分包含完整时间窗,60 秒预热只用于附加指标。
拿本轮真实的 Agent第6次提案作例子。 当时 Agent 调参组仍采用初始版。提案把电压噪声尺度从初始版的 0.030 调到 0.035,把 SOC 过程噪声尺度从 0.000010 调到 0.000008。回放之后,平均 RMSE 从 1.59477 降到 1.57586 pp;容量设低场景最大误差下降,容量设高场景最大误差只增加约 0.78%,没有超过 2%。它也通过了数值护栏,所以被收录。
这里的“收录”就是更新本组采用的参数快照,并保存评价证据。Agent第6次提案的历史探索起点实际是 Agent第4次提案,但它需要超过的是当时保留版。这两种关系会在后面的树形图中分开说明。
本轮开始前还做了人工修正:用 log(R0) 表示电阻状态,避免旧实现产生负电阻;把上一轮不允许最大误差增加的规则改为逐轮最多增加 2%,并调整常规搜索步长等设置。这些修改在开跑前冻结,不能算作 Agent 自动发现的成绩,也不能把新旧两轮结果的差别全归因于换模型。
四、搜索结果:谁更早找到改进,谁最终误差更小?
先看两组的八次提案。图4上排是规则调参组,下排是 Agent 调参组。左侧画平均误差,右侧画每个场景最坏误差的变化。
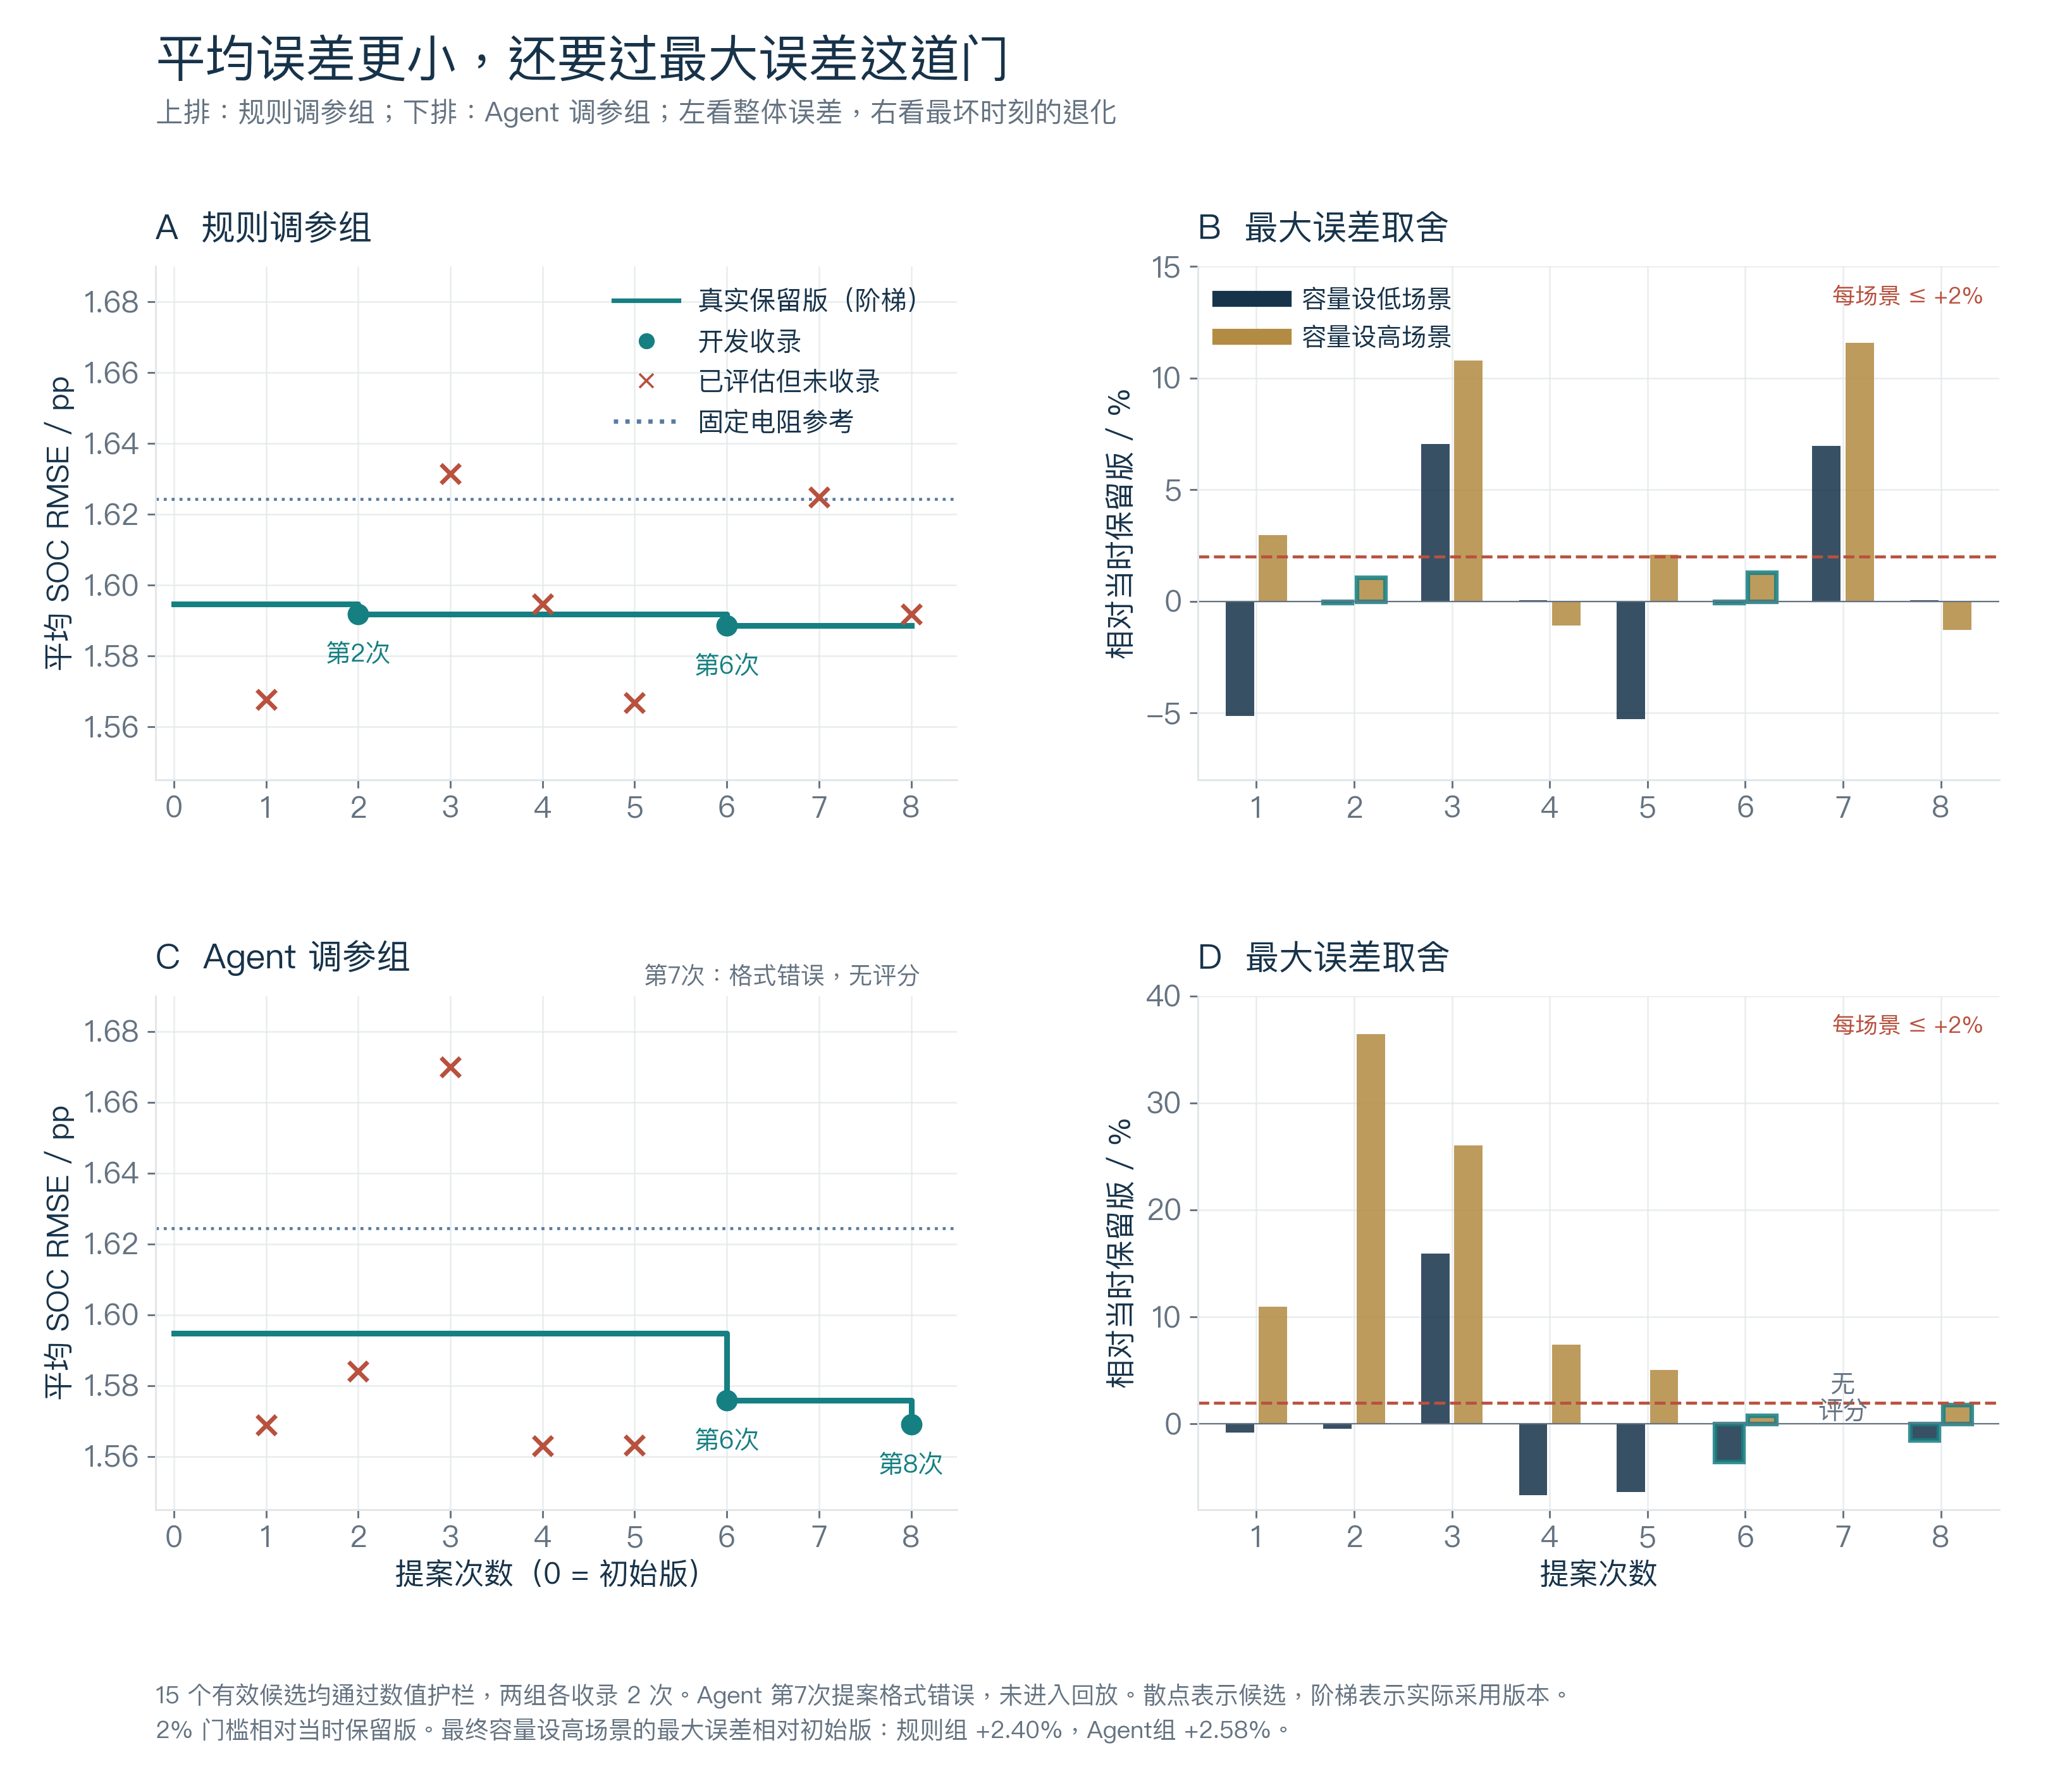
图4|绿色阶梯表示当时实际采用的版本,圆点表示收录,红叉表示未收录。横轴是提案次数,0 表示初始版,不是运行时间。
左上图中,规则调参组第2次就获得第一次收录,第6次再改善一次;左下图中,Agent 调参组直到第6次才首次收录,第8次继续改善。 Agent 组后两次的台阶更大,但第一次找到可用改进更晚。因此,本轮可以说它最终降幅更大,不能说它更早或更快。
为什么有些红叉比绿色阶梯还低,却没有被采用?对照右侧两图就能看出来:它们虽然平均误差较低,却使某个场景的最大误差增加超过了红色虚线所示的 2% 上限。例如,Agent第4次提案的平均误差为 1.56307 pp,是该组最低值,但容量设高场景的最大误差增加约 7.39%,所以被拒绝。规则第1次提案也因同一场景增加约 2.96% 而未收录。右侧两图的纵轴范围不同,应读刻度比较,不能直接比较柱子的像素高度。
最终,初始版、规则组最终版、Agent组最终版的平均误差分别为 1.59477、1.58863、1.56910 pp。Agent组最终版比规则组最终版低约 1.23%;比初始版低约 1.61%,绝对减少 0.02567 pp。这是小幅开发改进,不是准确率提高了 1.61 个百分点。
Agent第7次提案返回的 JSON 多了一个右花括号,没有通过格式检查,因此没有进入回放,也没有评分。它仍占用一次提案机会。两组各有八次机会,实际有效候选分别为八个和七个;相同提案次数不等于相同运行时间或调用费用。
平均误差下降,两个场景都变好了吗?
图5把两个场景分列,避免曲线混在一起:左列是容量设低场景,右列是容量设高场景。上排画完整 SOC 误差,中排画相对初始版的 SOC 估计变化,下排画电阻估计变化。金色虚线是规则组最终版,青绿色实线是 Agent组最终版,两条灰线是固定电阻参考和初始版。
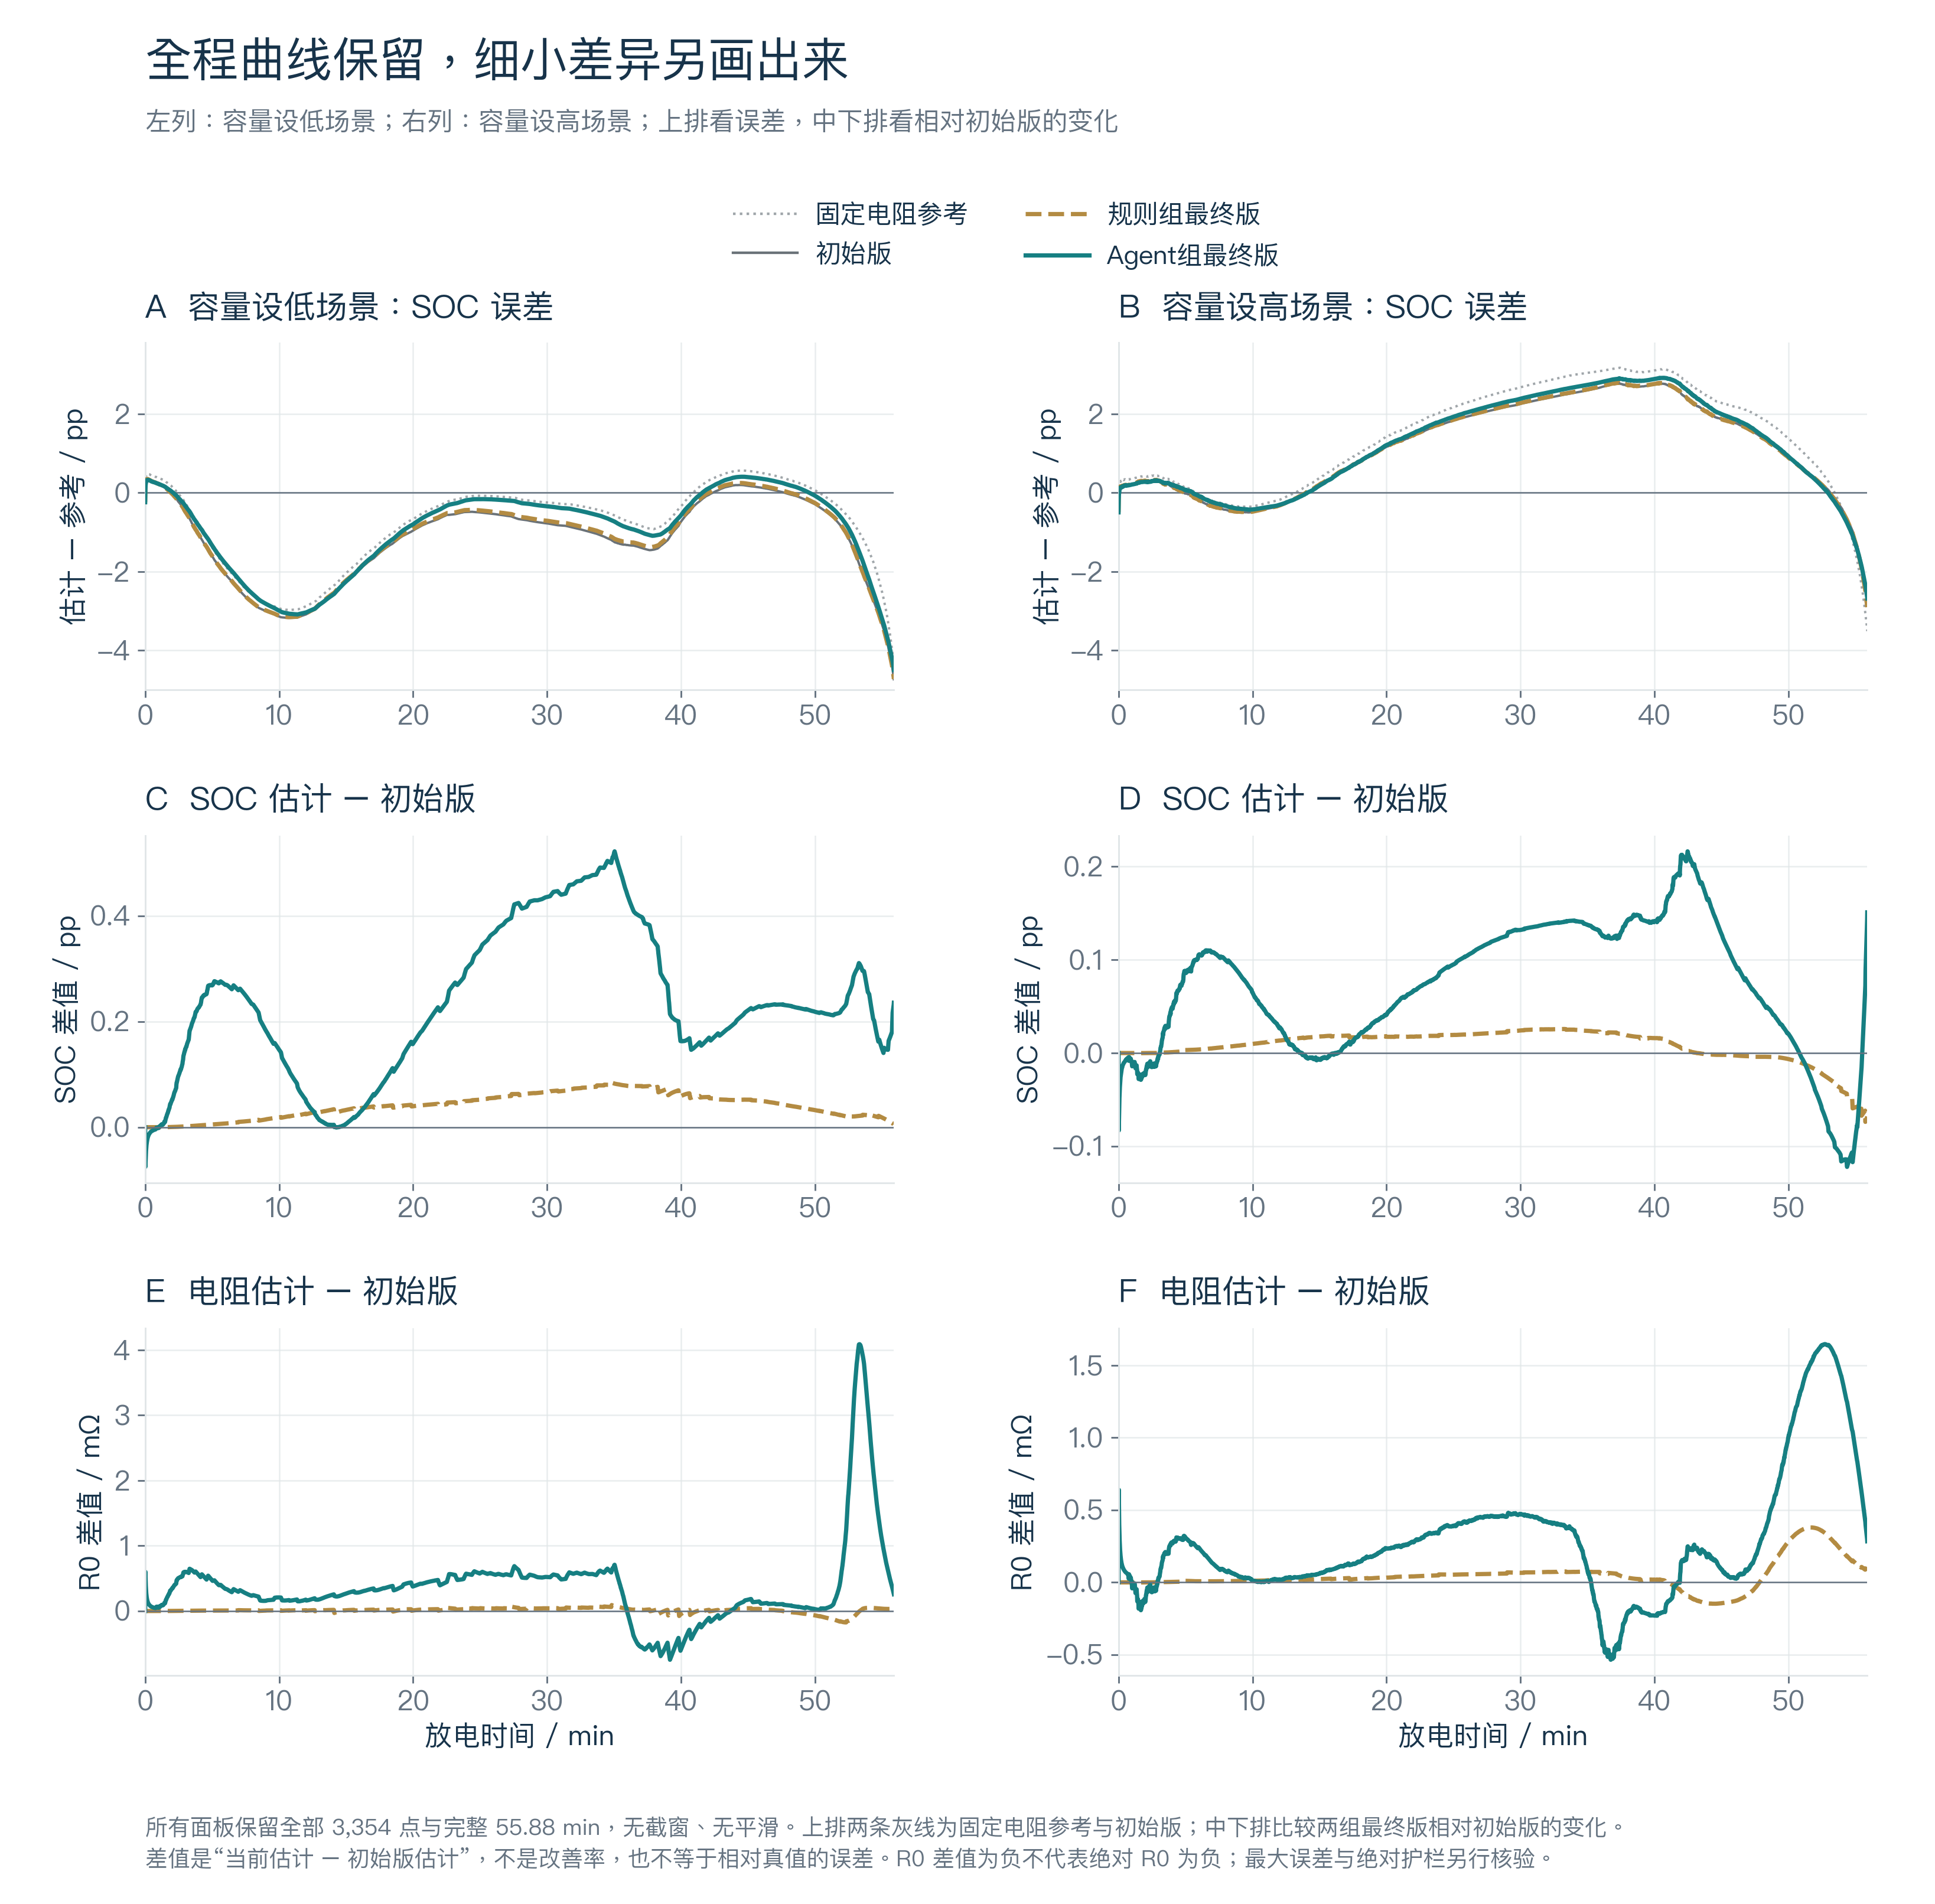
图5|上排越靠近零线,SOC 误差越小;中下排只表示“最终版减初始版”的变化,不能直接当作改善量。所有面板保留完整放电时间窗。
先看左列:容量设低场景原本有一段明显低估,Agent组最终版把 SOC 估计向上修正,幅度比规则组更大。 例如约30分钟处,误差由初始版的 −0.782 pp 变为 −0.346 pp,更靠近零线。这段修正有利于降低误差。
再看右列:容量设高场景在放电中段原本就估得偏高,再向上修正会使误差更大。 同样在约30分钟处,误差由 +2.249 pp 变为 +2.381 pp,反而远离零线。因此,本轮平均收益主要来自容量设低场景,并非两个场景都改善。即使在左列,约45分钟处原本已有正误差,继续向上移动也会变差。
下排显示,Agent组最终版的电阻估计相对初始版变化更明显。但变化幅度大不等于估计更准确,因为本轮没有独立电阻真值作为对照。读图时要分别回答:曲线移了多少,以及这次移动是否让误差更接近零。
五、树形记录:从哪里继续尝试,哪些结果真正被采用?
搜索过程不仅要记录第几次得了多少分,还要记录方案从哪里来。树形图把“继续探索”和“采用改进”分开展示。
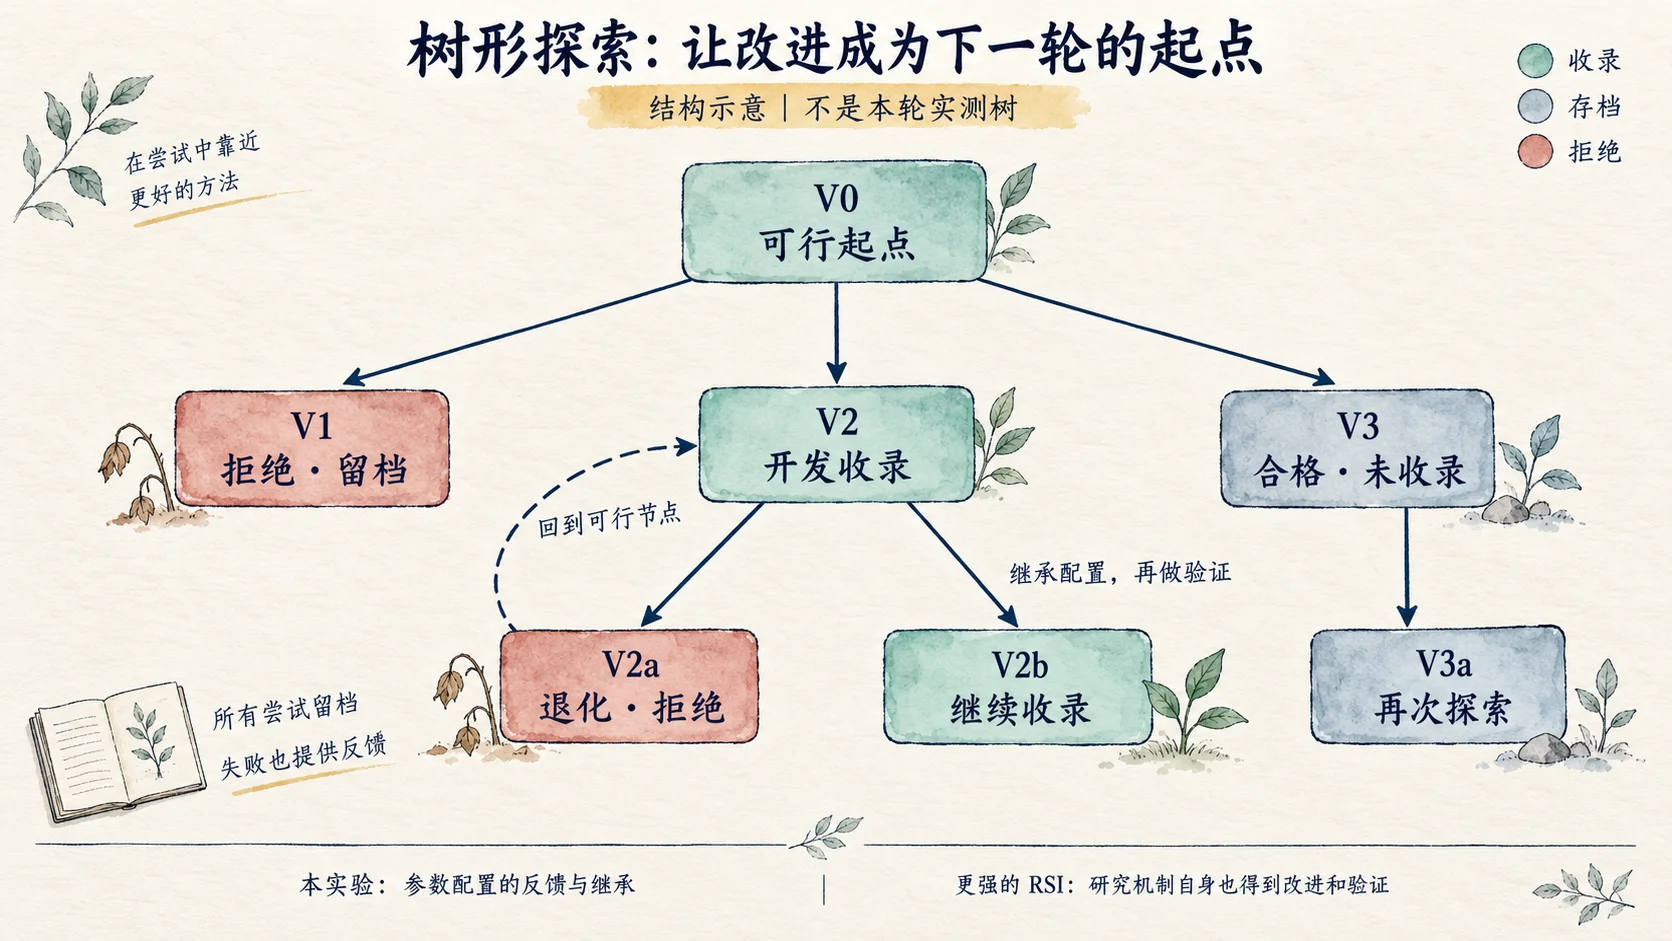
图6|概念示意。图中的 V0、V1 等是假想版本,帮助说明分叉、拒绝、回退与收录,不对应本轮的提案编号。
图6中,树向下长出一个节点,只表示又尝试了一个方案。 通过检验的改进可以被收录;没有被收录的尝试也会留档,为后续探索提供参数和失败原因。绿色节点才表示已经通过收录判断,分支更多或更深并不意味着改进更多。
这种做法借鉴了 autoresearch 的保留与回退流程,以及 DGM 的历史版本档案思路。DGM 会修改 Agent 自身代码,本实验仍只调整 SOC 估计器的参数。
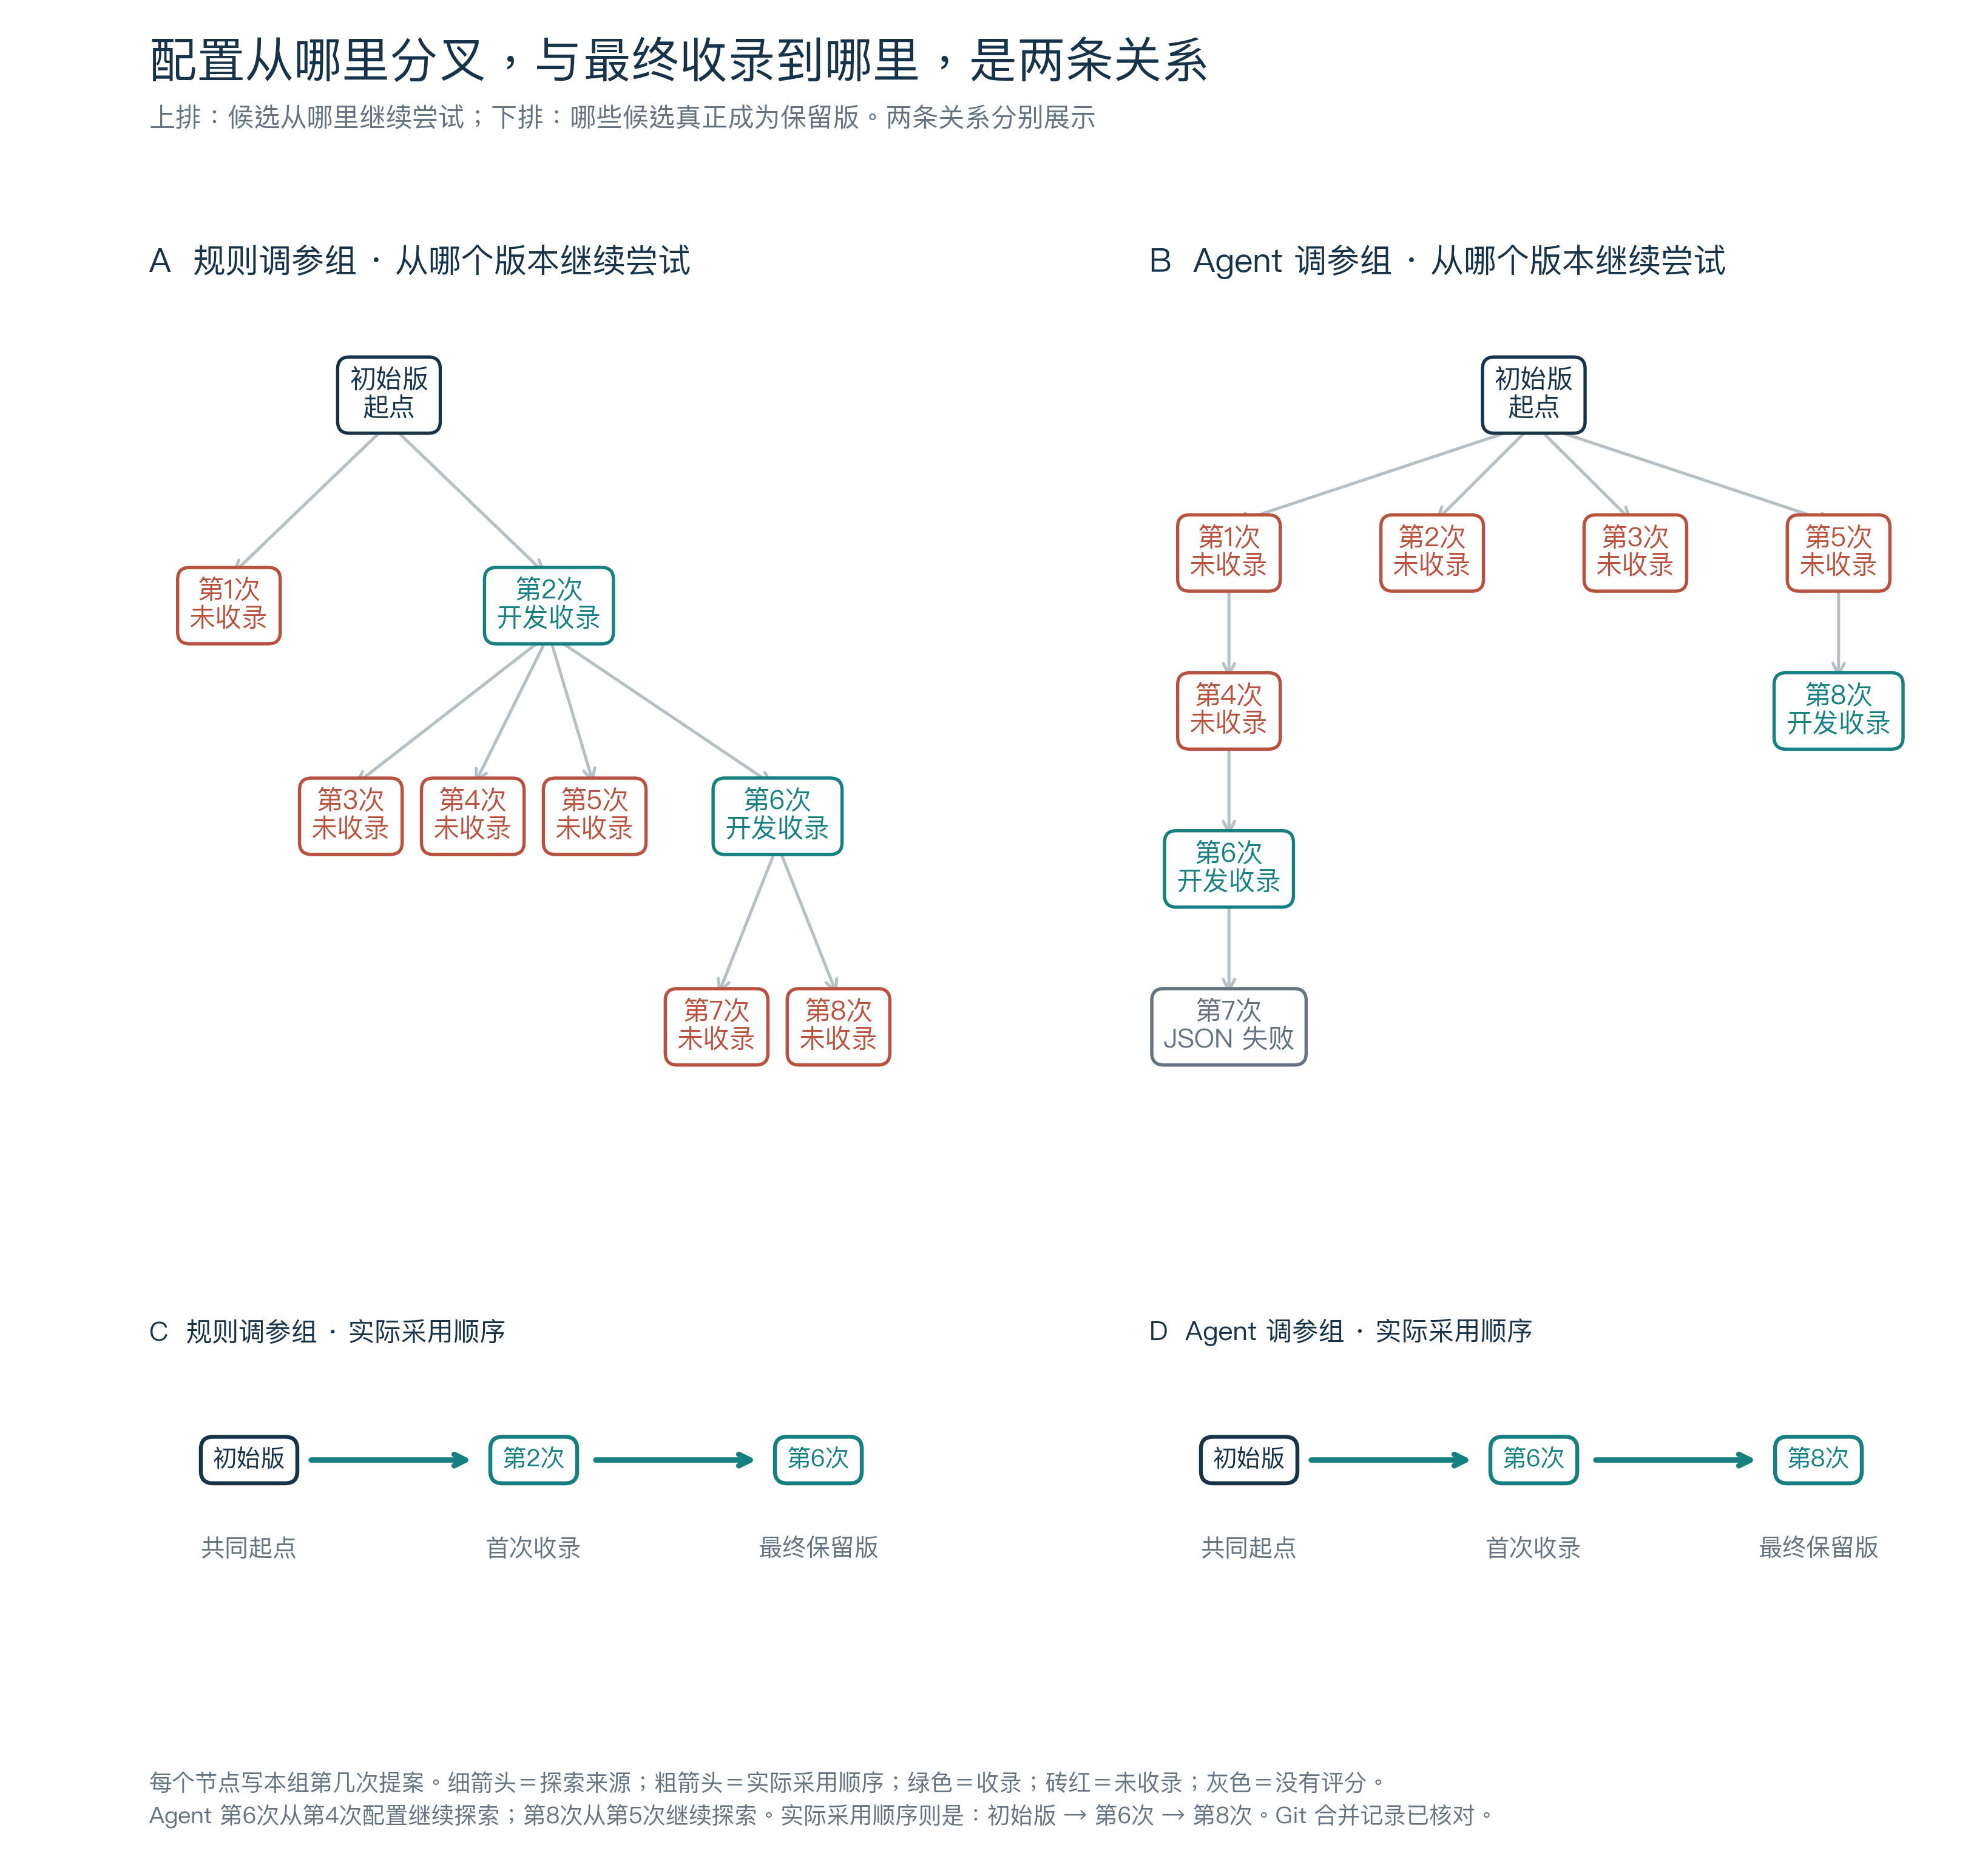
图7|左列为规则调参组,右列为 Agent 调参组。上排回答“从哪个版本继续尝试”,下排回答“哪些版本真正被采用”。节点上的“第几次”都指所在组的提案次数。
先看右上:Agent第1次和第4次提案都没有被收录,但第6次从这条探索路径产生,最后通过了检验。 这说明探索可以从未收录的配置继续,并不要求每次都从当前最佳版本出发。
再看下排,两组实际采用的顺序都很短。 规则调参组是“初始版→第2次→第6次”;Agent 调参组是“初始版→第6次→第8次”。其中,规则第6次和Agent第8次分别成为两组最终版。上排复杂的分叉,没有全部变成下排的保留版本。
Agent第8次提案尤其能说明两条关系的差别:它从第5次配置分叉,提案解释同时比较了第4、5、6次的结果;但接受判断需要超过的是当时已采用的第6次版本。于是,探索来源是第5次,参考经验包含多个历史结果,采用顺序却是第6次到第8次。
四次收录都对应真实的 Git 双父合并提交,连接此前采用版与新候选的评价记录。版本与结果因此可以追溯。但这只证明反馈进入了后续流程,尚不能量化历史经验带来了多少收益;要回答后一个问题,还需要无历史反馈的对照。
六、改进的取舍:平均误差下降,还改变了什么?
图8横轴统一为四个名称:固定电阻参考、初始版、规则组最终版、Agent组最终版。前两者提供参考,后两者是八次提案结束时各组实际保留的结果。
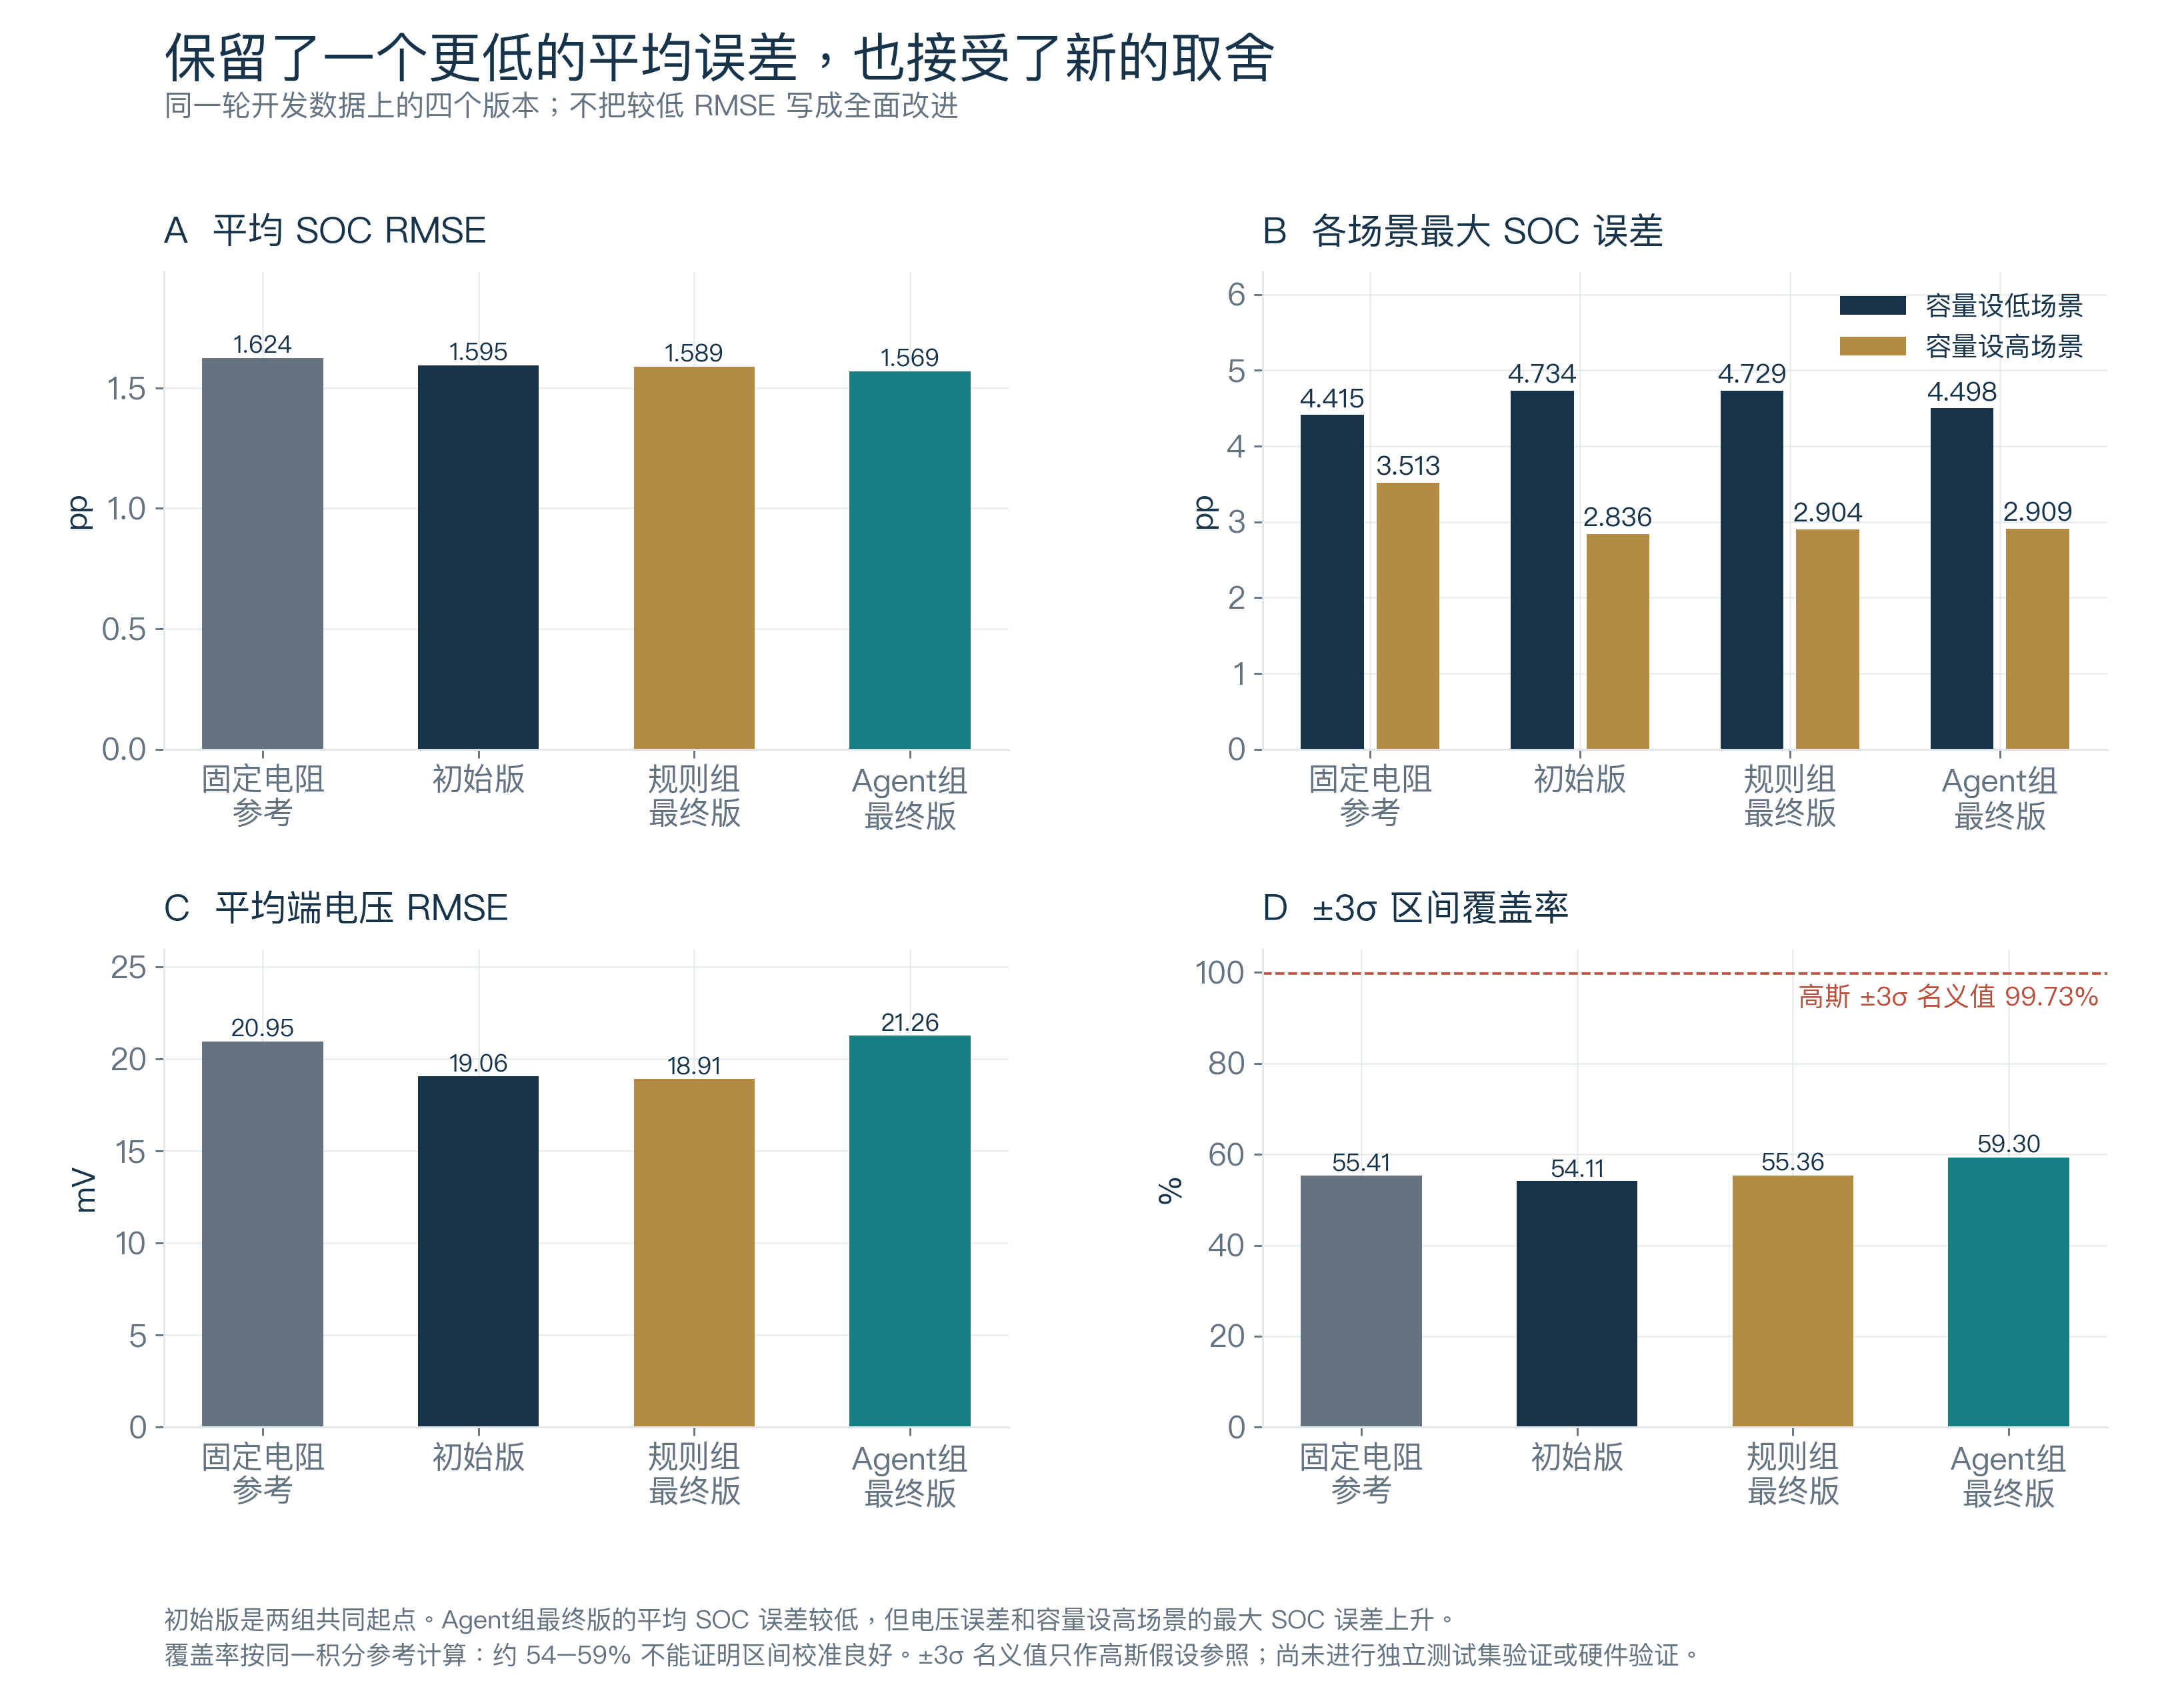
图8|左上看平均 SOC 误差,右上看两个场景各自的最大误差,左下看电压残差,右下看估计区间的覆盖率。
左上图中,Agent组最终版的柱子最低,但相对初始版只下降了一小段。右上图中,它在容量设低场景的最大误差下降,在容量设高场景却上升。 这两张图合起来说明:平均表现得到改善,同时接受了局部退化。
为什么单次最多允许增加 2%,最终累计退化却能超过 2%?因为每次判断都相对于当时采用版,而不是始终对照初始版。两次如果都用满额度,累计可达 1.02×1.02−1=4.04%。本轮容量设高场景的最大误差相对初始版累计增加:规则组约2.40%,Agent组约2.58%。两者符合本轮逐次收录规则,却不能被表述为“从起点到终点最多退化2%”。
左下图中,Agent组最终版的电压残差由初始版约19.06 mV升到21.26 mV。 SOC分数变好,未带来电压预测误差同步下降。右下图的区间覆盖率由约54.11%升到59.30%,也还不能证明不确定度估计已经校准;它需要结合区间宽度、分布假设和评分参考质量一起判断。
这轮实验让我更明确了一件事:找到平均误差更低的配置,只完成了研究的一部分。还需要事先规定允许怎样的取舍,并检查局部退化是否会逐轮累积。 如果工程上不接受这种漂移,下一轮应在运行前加入相对初始版的全局限制。
七、结语:一次小型概念验证,确认了什么?
这次是一项小型概念验证试验。它首先要回答的是:能否把 Agent 的参数建议,接入一条真实可执行、可评价、可回退、可继续的 BMS 研发流程?从本轮记录看,这个流程已经跑通。 为了让每一步都能检查,我把范围限定在一颗钠离子电芯的一段历史记录、两种输入误差场景,以及 SOC 估计器的两个可调参数上。
流程上的结论是,Agent 辅助的反馈改进闭环具有实现可行性。 模型提出参数,固定程序完成回放和评分,再按预先规定的门槛决定拒绝或收录;有效改动成为后续采用的版本,历史结果则进入下一次提案的上下文。Agent 组在八次提案机会中获得两次收录,两个改进版本及其评价证据都进入了 Git 记录。至此,“提出建议—运行试验—检查结果—保留改进—继续尝试”已经成为可以复查的实际过程。
结果上的结论是,本轮出现了可测量的小幅局部收益。 Agent组最终版的平均 SOC 误差比初始版低约1.61%,比规则组最终版低约1.23%。但它获得第一次收录更晚,而且容量设高场景的最大误差与电压残差有所增加。因此,本轮证据支持的是“在既定规则下找到了一个平均误差较低、允许部分指标退让的配置”,不能据此认定它优化得更快或所有指标都更好。
这项试验还让我看清了评价规则的重要性:如果只要求每次相对当前版本的最大误差增加不超过2%,局部退化仍可能逐轮累积。概念验证的产出,既包括两个可追溯的改进版本,也包括下一轮需要补上的全局约束。 这使后续实验有了具体的修改依据。
目前验证的范围是软件离线回放与参数优化。最终测试分区尚未评分;单次运行也不足以判断 Agent 是否稳定优于规则调参,或历史反馈本身贡献了多少收益。下一步应冻结版本和评价规则,在独立工况上复测,并增加重复运行及无历史反馈对照。更强意义上的 RSI 还需要检验:系统对研究方法本身的改变,是否确实帮助了后续改进。
回到这篇笔记的起点,我的阶段性结论是:在一个足够小、边界清楚的钠电 SOC 任务上,Agent 辅助的树形探索与反馈闭环能够运行,也能够留下经过检验的局部改进。 这为后续扩大数据与任务范围提供了一个可复查的起点;下一阶段的重点,是检验这份小收益能否稳定重复,并在新的工况下继续成立。
整理说明:公开数据作者为 Pablo Rodríguez Iturriaga、Sai Thatipamula、Simona Onori,数据集 v2 按 CC BY 4.0 许可使用。、
登录后可以留言
Peter YU2026/10/16 18:23:00
钠电和锂电的不同特性下的SOC的估计器既然一定不同,就也许也能RSI得到在AIDC削峰填谷的场景下纳锂协同的SOC估计器的优化带来的充放电管理的优化,带来对AIDC工程并网运营成本的动态最优解。