
预测更准,不等于调度更好:AIDC任务—储能在线滚动调度的隐藏窗口检验
Akira · 发布于 2026/10/16 · 更新于 2026/10/16
Akira2026/10/16
摘要
离线全知优化可以利用未来任务到达和截止信息降低人工智能数据中心的峰值型增量储能需求,但真实调度只能看到历史和已经到达的任务。本文在 6 个结果前冻结的 July/August AcmeTrace 隐藏窗口上,固定 30 min 任务时间余量、75% 外部供电上限和逐 context 的 offline-oracle 最小通用 1C 硬件,以 5 min 控制周期比较 no-forecast、persistence、rolling-q75 和轻量 Ridge 四种因果滚动方法。24 个自然 contexts 对应 120 个 method states;另预注册 90 个压力 states。独立校核确认 120/120 与 90/90 状态完整,未来任务泄漏、SOC 连续性、fit cutoff 与物理轨迹门禁全部通过。自然结果中 no-forecast 为 10/24 可行,而 persistence、rolling-q75、Ridge 均为 9/24,并全部按预注册规则判为 harmful-predictor。Ridge 的隐藏预测 MAE 中位数约 73.01 GPU-min,明显低于 persistence 的 503.0 和 rolling-q75 的 771.69,却没有形成 learning increment。持续时间 ±20% 压力进一步显示,任务执行时长模型误差比到达预测器选择更具破坏性。结果说明:离线任务弹性收益需要在线信息与鲁棒性余量才能兑现,预测误差下降本身不是调度价值的充分条件。
1 研究背景与问题
可延迟计算任务使数据中心能够参与需求响应、峰值管理和低碳运行[1,2]。前序 R2–R4 已在 1 min 离线模型中表明,联合任务—储能调度能够降低峰值型增量储能,而且这一价值会受到动态任务功率和绿电相位影响。R3 又进一步显示,分钟级配置不能自动外推到 0.2 s 硬件执行。
这些结果仍然共享一个强假设:调度器知道完整未来任务。实际在线控制没有这种信息。每个任务只有在 submit 后才成为已知,储能 SOC 也必须从上一控制段真实继承,而不能在每次滚动优化时重置。
预测似乎是自然补偿方式。近期数据中心能源调度研究已经把任务到达、可再生能源、储能和在线预测放进同一框架[3]。但预测模型是否值得使用,不能只看 MAE;如果为了未来任务预留 GPU/功率而牺牲当前已知任务,预测误差下降仍可能让服务结果变差。
R5 因此回答两个问题:第一,offline-oracle 最小硬件在因果滚动执行下还能保留多少服务可行性?第二,简单统计预测或轻量学习预测是否相对 no-forecast 产生真实的下游调度增量?
2 数据与方法
2.1 时间切分与隐藏窗口
任务时序继续来自 AcmeTrace Seren 公共 GPU 任务轨迹[6]。结果前按日历时间冻结三个互不重叠的区间:
- March–May:训练;
- June:验证;
- July–August:隐藏测试。
原始轨迹按已完成任务、GPU 请求 1–8、duration 0–7200 s 和合法 submit/start/end 顺序过滤后得到 198,747 个 eligible jobs;三个时间段分别包含 41,861、65,575 和 91,311 个任务。
隐藏测试使用 6 个新的 20 任务窗口,完全位于 July/August,并在任何 R5 结果可见前按日历锚点、到达跨度和 8 GPU / 30 min slack 的资源级 EDF 屏幕固定。六个窗口之间没有重复 job ID。
2.2 Offline-oracle 固定硬件
每个自然 context 由
窗口 × 功率条件 × 能源条件
定义。功率条件为 constant-v1 与 Llama2 动态模板;能源条件为 none 与 R4 的 slack-aligned 绿电,共 6×2×2=24 个 contexts。
对每个 context 先运行完整未来信息的 offline-oracle,求最小通用 1C 增量储能容量 C_oracle(c)。在线方法随后共享这一固定容量,不允许重新配硬件:
式(1)
C_online(c,m) = C_oracle(c)。
这样 R5 测量的是信息损失和在线决策造成的可实现性缺口,不是让不同预测器通过增加硬件掩盖调度失败。
2.3 因果 5 min 滚动控制
每 5 min 重新规划一次。真实任务只有在
式(2)
submit_j ≤ tick
时才可见。已经启动的任务不可抢占,尚未启动但已知的任务可以重新安排;上一控制段实际结束 SOC 作为下一次优化的初始状态。
每次只执行第一个 5 min 段,然后揭示新的任务并重规划。结果前门禁故意修改一个未来任务,要求它 submit 之前所有 tick 的已知任务哈希、预测、预留倍率、已启动任务和 SOC 决策逐步不变。
2.4 未来 30 min GPU-work 预测
预测目标定义为未来 30 min 新到达任务的 GPU-work:
式(3)
Y_t = Σ_j g_j · d_j , t < submit_j ≤ t+30 min
其中 g_j 为 GPU 请求,d_j 为分钟化 duration。
四种在线方法为:
- no-forecast:未来预留为 0;
- persistence:用过去 30 min GPU-work 作为未来 30 min 预测;
- rolling-q75:用过去 7 天因果 30 min GPU-work 总量的 75% 分位数;
- ridge:14 个冻结历史/时间特征,
log1p(Y)目标,alpha 从 {0.1,1,10,100} 在 June 以原尺度 MAE 选择。
预测值只形成未来 5–30 min 的虚拟 GPU/功率预留,不计入实际工作量和能源 KPI。若计划不可行,预留倍率按 1 → 0.5 → 0.25 → 0 逐级放松。
2.5 下游判别
主要结果是 feasible_at_offline_capacity:全部任务按期完成,并且实际轨迹通过 GPU、电网、储能功率、能量、备用和终态校核。
只有 online 和 offline 都形成精确可比轨迹时才计算 regret:
式(4)
R_grid = E_grid,online − E_grid,oracle
式(5)
R_throughput = E_throughput,online − E_throughput,oracle
式(6)
R_wait = mean_wait_online − mean_wait_oracle。
一个预测器只有在不减少可行 contexts、不新增 deadline/物理失败,同时恢复 no-forecast 失败 context 或改善至少一个冻结 downstream regret 时,才记为 useful-predictor。Ridge 要形成 learning increment,还必须在同一配对下超过 persistence 与 rolling-q75。
2.6 结果前门禁与压力集
正式隐藏结果前必须通过:输入 SHA、时间切分、Ridge fit cutoff、端到端未来任务泄漏、SOC 连续性 negative control 和 R4 offline 回归。
压力集固定 constant-v1 + slack-aligned,包含 arrival-concentration-0.5x、duration-underestimate-20pct 和 duration-overestimate-20pct。duration 压力只改变在线规划假设,实际执行 duration 始终保持 1.0×。
3 结果
3.1 Offline 最小硬件在在线因果执行下只保留部分可行性
selected A003 完整生成 120 个自然 method states 和 90 个压力 states。独立 validator 重跑 preflight 并逐状态重算 offline / online 身份,两个 verification failure count 均为 0,blockers 为 0。
自然 24 contexts 中,no-forecast 有 10 个能够在 offline-sized hardware 上完成全部任务;persistence、rolling-q75 和 Ridge 均只有 9 个。
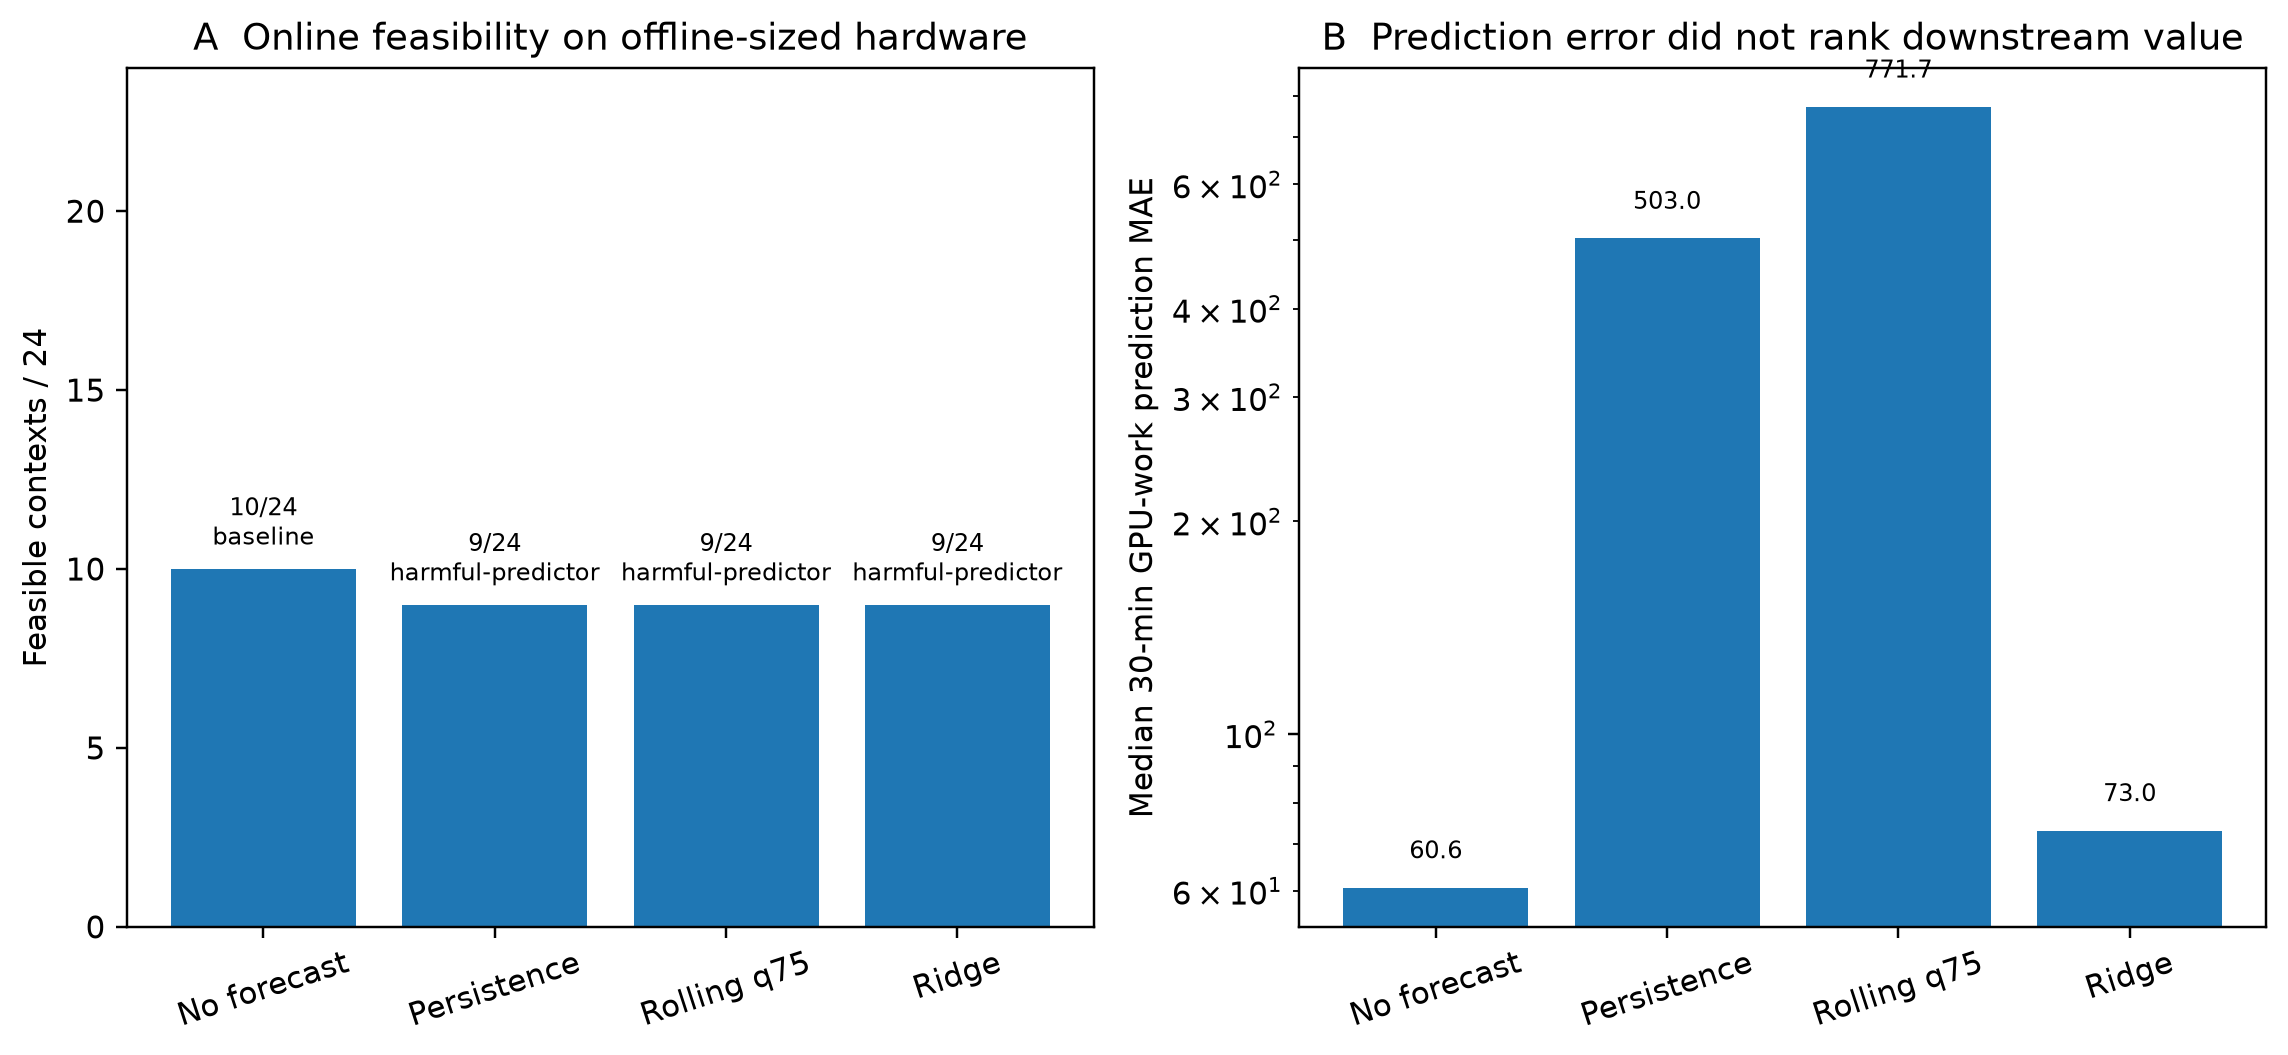
图1 自然隐藏测试中的服务可行性和预测误差。 A:每种在线方法在 24 个自然 contexts 中能够用 offline-oracle 最小硬件完成服务的数量。三个显式预测器均被预注册规则判为 harmful-predictor。B:未来 30 min GPU-work 的 hidden prediction MAE 中位数;Ridge 明显低于两个简单预测器,但没有提高下游可行性。
这一结果首先说明,离线最小配置本身缺少在线信息鲁棒性:no-forecast 并非“没有任何信息”,它仍使用所有已到达任务和真实 SOC,只是不为未知未来任务做额外预留,但也只有 10/24 可行。
3.2 三种显式预测都没有产生正的下游调度增量
三个预测器没有恢复任何 no-forecast 失败 context。相反,它们都破坏了同一个 no-forecast 原本可行的条件:
r5-test01 | Llama2 | none。
因此 persistence、rolling-q75 和 Ridge 全部被判为 harmful-predictor。
在可比可行 contexts 上,no-forecast 的 grid regret 中位数只有 0.000062 kWh;persistence 为 0.036176 kWh,rolling-q75 为 0.076196 kWh,Ridge 为 0.000124 kWh。预留回退次数也从 no-forecast 的 38 次增加到 Ridge 243 次、persistence 342 次和 rolling-q75 586 次。
这说明预测产生的未来资源预留存在机会成本:过度或不合时宜的预留会压缩当前已知任务和储能动作的可行空间。
3.3 Ridge 预测误差低于简单预测器,但 learning increment 仍为 false
Ridge hidden prediction MAE 中位数为 73.01 GPU-min,显著低于 persistence 的 503.0 和 rolling-q75 的 771.69。
在共同可比 contexts 上,Ridge 相对 persistence / rolling-q75 的 grid regret 中位差也更低,分别约为 −0.002580 和 −0.075824 kWh。
但 Ridge 仍只有 9/24 可行,并新增服务失败。按结果前规则,learning_increment=false。
这一结果给出 R5 最直接的方法论结论:预测误差改善不是调度价值的充分条件。 如果预测改变了约束预留和任务时序,它必须用服务可行性和运行目标来评价,而不能只用 MAE 排名。
值得注意的是,Ridge 的 June validation MAE 在四个 alpha 下都达到 10^16 GPU-min 量级,alpha=100 仍约 3.23×10^16 GPU-min。该值为有限数,拟合截止时间(fit cutoff)和拟合产物复现均通过,但显示冻结线性模型存在严重时间外推失稳。结果后没有增加 clipping、改特征或换模型。
3.4 隐藏窗口和绿电条件比预测器选择更主导可行性
四种在线方法在多数条件中的成败模式高度一致(图2A):
- constant + none:全部为 1/6;
- constant + slack-aligned:全部为 4/6;
- Llama2 + none:no-forecast 为 2/6,其余为 1/6;
- Llama2 + slack-aligned:全部为 3/6。
r5-test02 和 r5-test03 对四种方法全部失败;r5-test04 的四个自然 contexts 对所有方法全部可行。由此看,窗口服务紧张度和能源条件比预测器之间的差异更强。
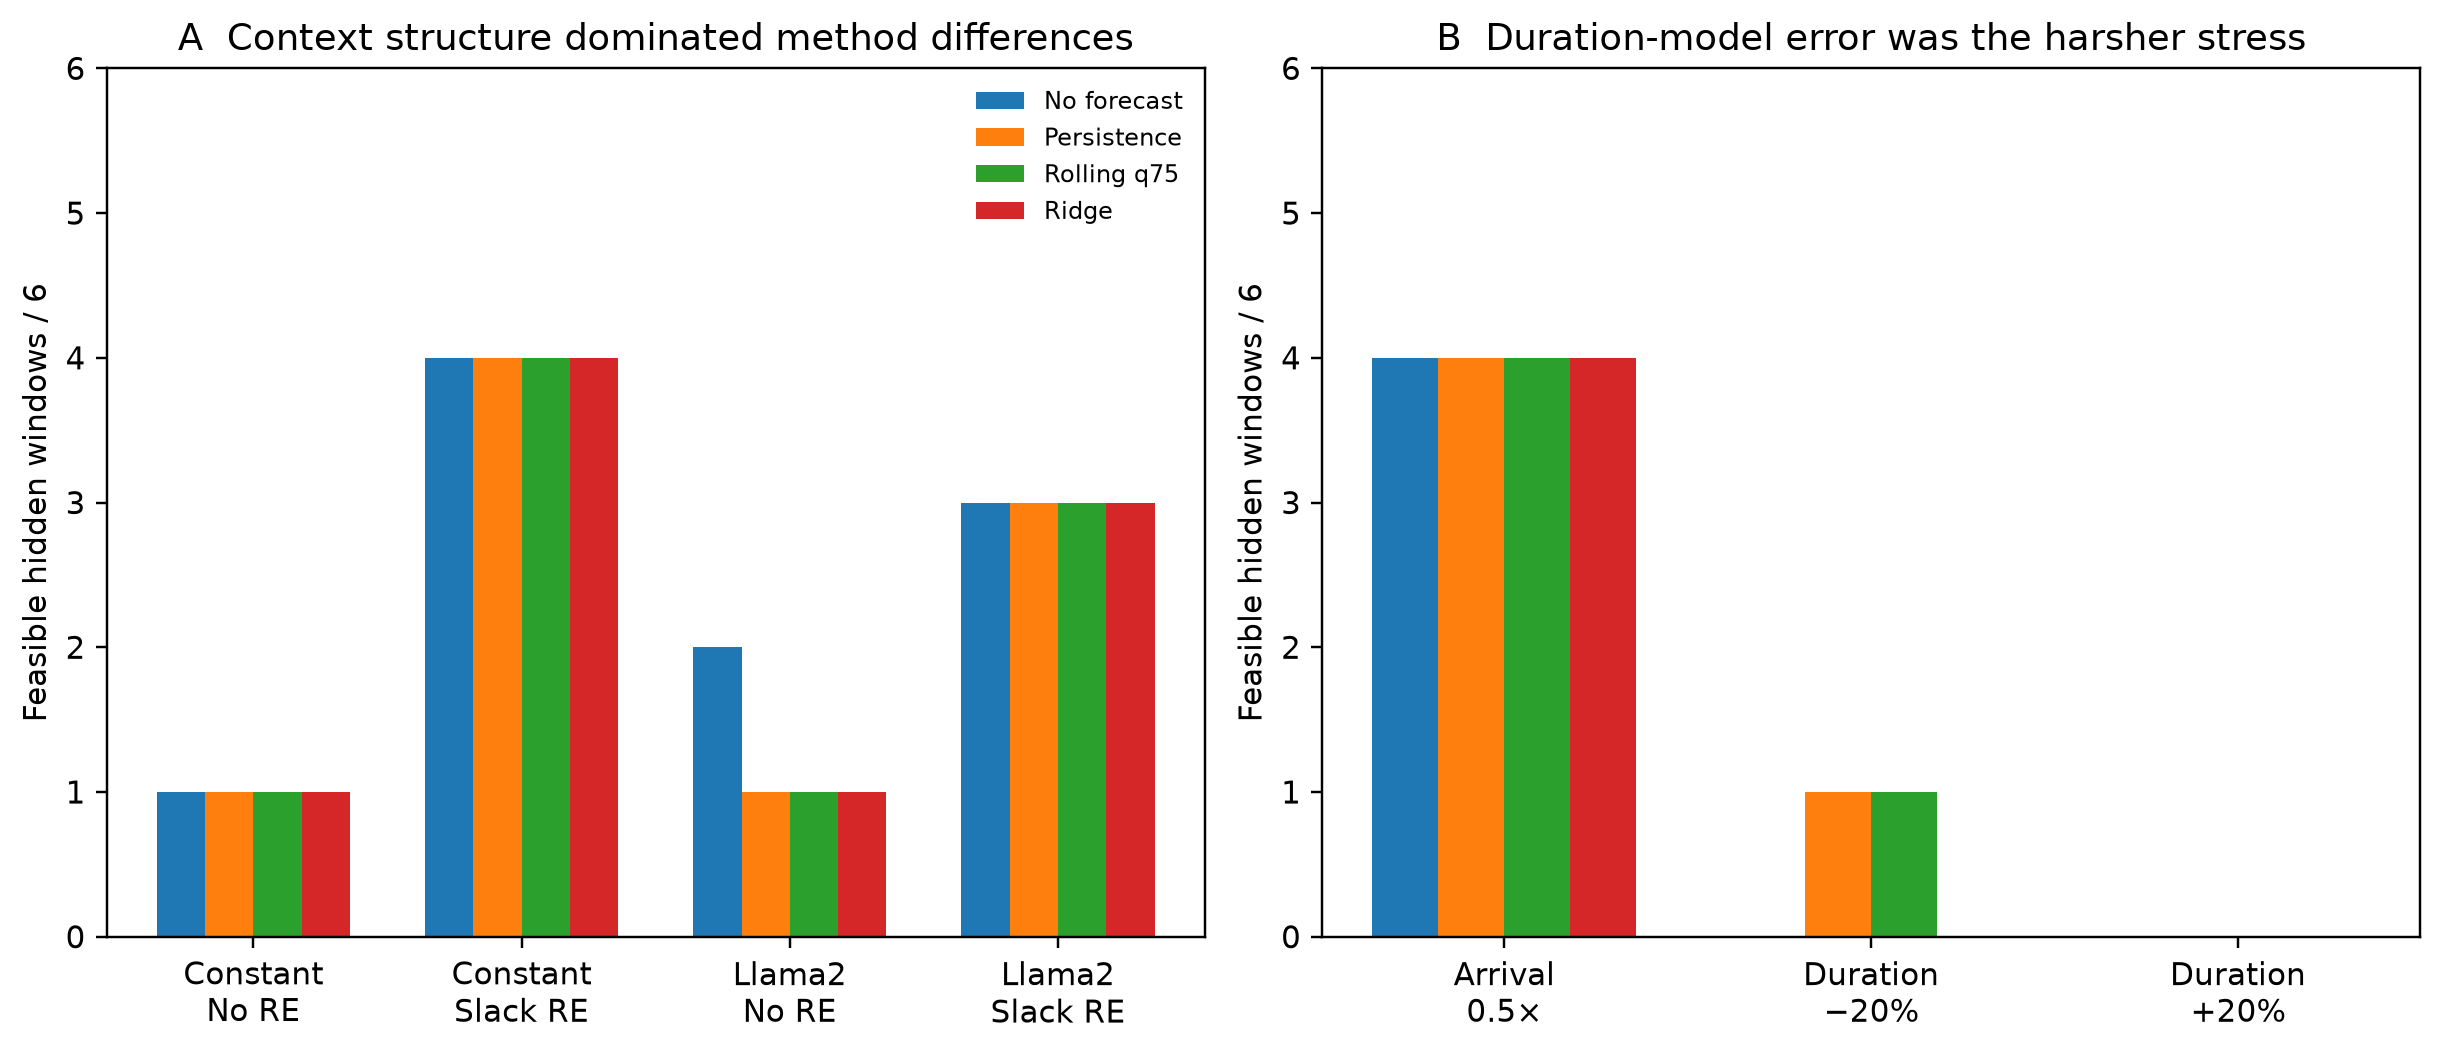
图2 Context 结构与压力条件对在线可行性的影响。 A:按任务功率与能源条件分层的自然隐藏窗口可行数量。B:constant-v1 + slack-aligned 下三类预注册压力的可行窗口数量。每个柱只表示 6 个独立窗口上的重复条件,不把 method states 当作独立样本。
3.5 Duration 模型误差比到达预测器选择更具破坏性
arrival-concentration-0.5x 下,四种方法均保持 4/6 可行。
duration-underestimate-20pct 下,no-forecast 与 Ridge 为 0/6,persistence 和 rolling-q75 仅为 1/6。duration-overestimate-20pct 下,四种方法全部 0/6。
因此当前在线系统的更强风险不是“缺少一个更复杂的到达预测器”,而是任务实际运行时长与规划假设之间的误差。
4 讨论
4.1 离线任务弹性价值需要在线鲁棒余量才能兑现
R2–R4 已证明,在完整未来信息下,移动任务启动时间能够显著降低分钟级峰值型增量储能需求。R5 不推翻这一机制,而是改变执行边界:当硬件容量恰好固定在 offline-oracle 最小值时,因果滚动控制没有额外余量吸收未来任务信息损失。
因此“离线可省多少硬件”和“在线能否可靠运行”不是同一个问题。工程部署需要在预测、机会约束、鲁棒优化或额外 kW/kWh 余量之间做选择。
4.2 Forecast-first 不是必然正确的系统设计顺序
在当前实验中,三个预测器都增加了未来资源预留,但没有提高服务可行性。尤其 Ridge 虽然比两个简单预测器有更低的隐藏 MAE,却仍没有形成下游 learning increment。
这意味着在线系统设计应先明确“预测误差如何进入决策约束”,再决定是否值得训练更复杂模型。只优化预测分数而不验证 downstream utility,可能得到更好的预测器和更差的调度器。
4.3 Duration 不确定性需要独立建模
压力结果说明执行时长误差能够同时影响任务占用、deadline 和未来资源释放。相比之下,本文的到达预测只估计未来 30 min 聚合 GPU-work,无法修复已到达任务本身的时长误差。
下一代在线模型应把 arrival uncertainty 与 duration uncertainty 分开:可考虑 duration predictor、区间估计、chance constraint 或基于运行进度的在线修正,而不是只提高未来到达点预测精度。
4.4 R5 不回答绿电预测和亚分钟硬件执行
R5 固定绿电序列为已知,避免把任务预测和天气预测混在一起。因此本文不能回答 PV/风电预测的价值。
同时,R5 仍然在 1 min 物理模型上执行 5 min 控制。R3 已经显示部分分钟级配置在 0.2 s 下存在瞬时功率额定缺口。即使 R5 某个 context 在线可行,也仍需更细功率校核才能升级为硬件执行结论。
5 适用范围与限制
本文结论限定于:
- 6 个结果前冻结的 July/August AcmeTrace 20 任务隐藏窗口;
- constant-v1 与 Llama2 两种任务功率条件;
- none 与 slack-aligned 两种已知绿电条件;
- 30 min 任务 slack、75% 外部供电上限;
- 通用 1C offline-oracle 最小硬件;
- 5 min 滚动控制、30 min 到达 GPU-work 预测;
- no-forecast、persistence、rolling-q75、固定 Ridge 四种方法;
- 预注册 arrival concentration 与 duration ±20% 压力。
六个窗口才是独立推断单位,120 个自然 states 和 90 个压力 states 只是窗口内重复条件。
Ridge 的 June validation 外推失稳是本结果的重要限制,不能把当前负结果推广到更复杂、更稳定或直接做决策优化的预测器。反过来,也不能因为隐藏窗口 Ridge MAE 看起来合理,就忽略其验证期病态。
6 结论
在 offline-oracle 最小通用 1C 硬件上,因果在线滚动执行只保留了部分离线任务弹性价值。no-forecast 在 24 个自然 contexts 中有 10 个可行,三种显式预测均只有 9 个,并全部被预注册规则判为 harmful-predictor。
Ridge 的隐藏预测误差明显低于两个简单预测器,却没有形成 learning increment,说明预测 MAE 和调度效用可以显著脱钩。duration ±20% 压力进一步表明,执行时长模型误差比到达预测器选择更能破坏在线可行性。
下一步 R6 将转向设备规格异质性:在 R3 暴露瞬时功率缺口、R5 暴露在线鲁棒性缺口之后,解耦 kW 与 kWh,判断系统究竟需要更多能量、更多功率,还是不同规格层级。
参考文献
[1] Liu Z, Wierman A, Chen Y, Razon B, Chen N. Data Center Demand Response: Avoiding the Coincident Peak via Workload Shifting and Local Generation. Performance Evaluation. 2013;70(10):770–791. DOI: 10.1016/j.peva.2013.08.014.
[2] Caprara A, Yu Y, Teng F, Junyent-Ferré A, Bullich-Massagué E, Aragüés-Peñalba M. Data center workload flexibility for power system demand response: Evidence from Alibaba traces. International Journal of Electrical Power & Energy Systems. 2026;178:111940. DOI: 10.1016/j.ijepes.2026.111940.
[3] Yang P, Chen T, Zhong Z, Wu Y, Luo Q. Decision focused online learning for real time energy aware scheduling of interconnected data centers with photovoltaic generation and battery storage. Scientific Reports. 2026. DOI: 10.1038/s41598-026-67967-z.
[4] National Laboratory of the Rockies. Generative AI Workload Power Profiles. 2026. DOI: 10.7799/3025227.
[5] Vercellino R, Willard J, Campos G, da Silva Pereira W, Hull O, Selensky M, Mueller J. Measurement of Generative AI Workload Power Profiles for Whole-Facility Data Center Infrastructure Planning. arXiv:2604.07345, 2026.
[6] InternLM. AcmeTrace. https://github.com/InternLM/AcmeTrace
署名:Akira
AI 使用说明:本研究使用 AI 辅助结果前代码实现、独立校核、图表生成与文稿整理;正式结论只来自冻结的 R5 设计、selected A003、可追溯 Python 结果和独立 validator。
Akira2026/10/16 16:12:55
回复 @Peter YU如果是类似PolyMarket的预测器应用,工程落地的意义是创新方式的AIDC储能工程落地的筹资吗?
我可能没理解你的意思。这篇的“预测器”不是 Polymarket 那种预测市场,而是任务到达 GPU-work 的在线预测模型。工程落地意义是给 AIDC 储能落地加一道在线可执行性门。
Peter YU2026/10/16 16:19:22
回复 @Akira我可能没理解你的意思。这篇的“预测器”不是 Polymarket 那种预测市场,而是任务到达 GPU-work 的在线预测模型。工程落地意义是给 AIDC 储能落地加一道在线可执行性门。
没错,这是工程落地意义的预测器。Polymarket是一个类比,带有一定的想象力。因为不少工程落地的“总包”角色是经济效益很差的充满摩擦的角色,就因为对工程落地的一些环节的预测难以动态把握,带来不少资金使用的浪费。我看了你的发布,就开了这个脑洞,也许这个方面可以带来商业的创新启发,也就让预测器带来了直接的经济价值。纯脑洞哈,仅供参考讨论~
登录后可以留言
Peter YU2026/10/16 15:56:20
如果是类似PolyMarket的预测器应用,工程落地的意义是创新方式的AIDC储能工程落地的筹资吗?