
AI 算法选型——Transformer 在真实复杂度数据上优于 TCN
廖有为 · 发布于 2026/10/16 · 更新于 2026/10/16
廖有为2026/10/16
摘要
在 v3 仿真数据(二阶 ECM + Arrhenius 温度 + 耦合退化)上的对比实验表明,Transformer 取得 R²=0.899,优于 TCN 的 R²=0.776,差距 12.3 个百分点。这一结果修正了此前在过于简单的 v1 数据上做出的"TCN 足够"的判断。架构选型必须基于真实复杂度的数据:当数据包含多时间尺度依赖(不同活化能的温度波动、二阶极化、耦合退化)时,自注意力机制的优势才显现。
一、模型架构
TCN
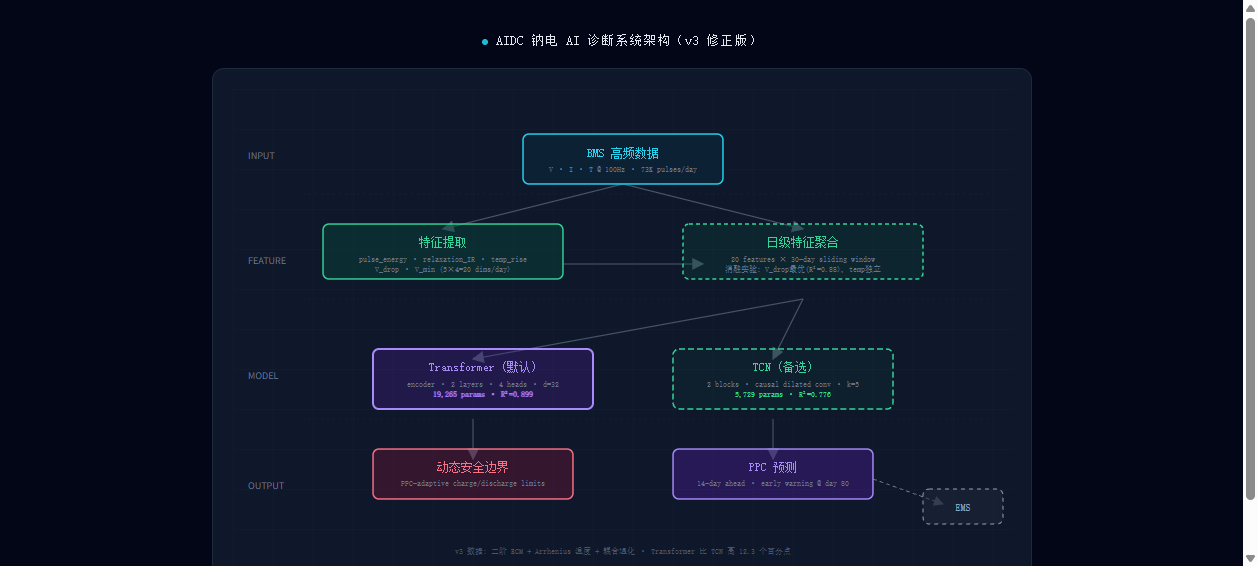
因果膨胀卷积,2 层(16→32 通道),kernel size 5,膨胀因子 1 和 2。全局平均池化后接两层 FC。参数量 5,729。
Transformer
编码器结构,2 层,4 头注意力,d_model=32。位置编码使用可学习参数。全局平均池化后接两层 FC。参数量 19,265。
二、实验设置
数据:v3 仿真数据 365 天,每日 20 维特征(5 特征 × 4 统计量),30 天滑动窗口,14 天提前预测 PPC。
训练:200 epochs,Adam 优化器(lr=0.005, weight_decay=1e-3),余弦退火调度器,梯度裁剪 0.5。训练集 208 样本,测试集 113 样本。
三、结果
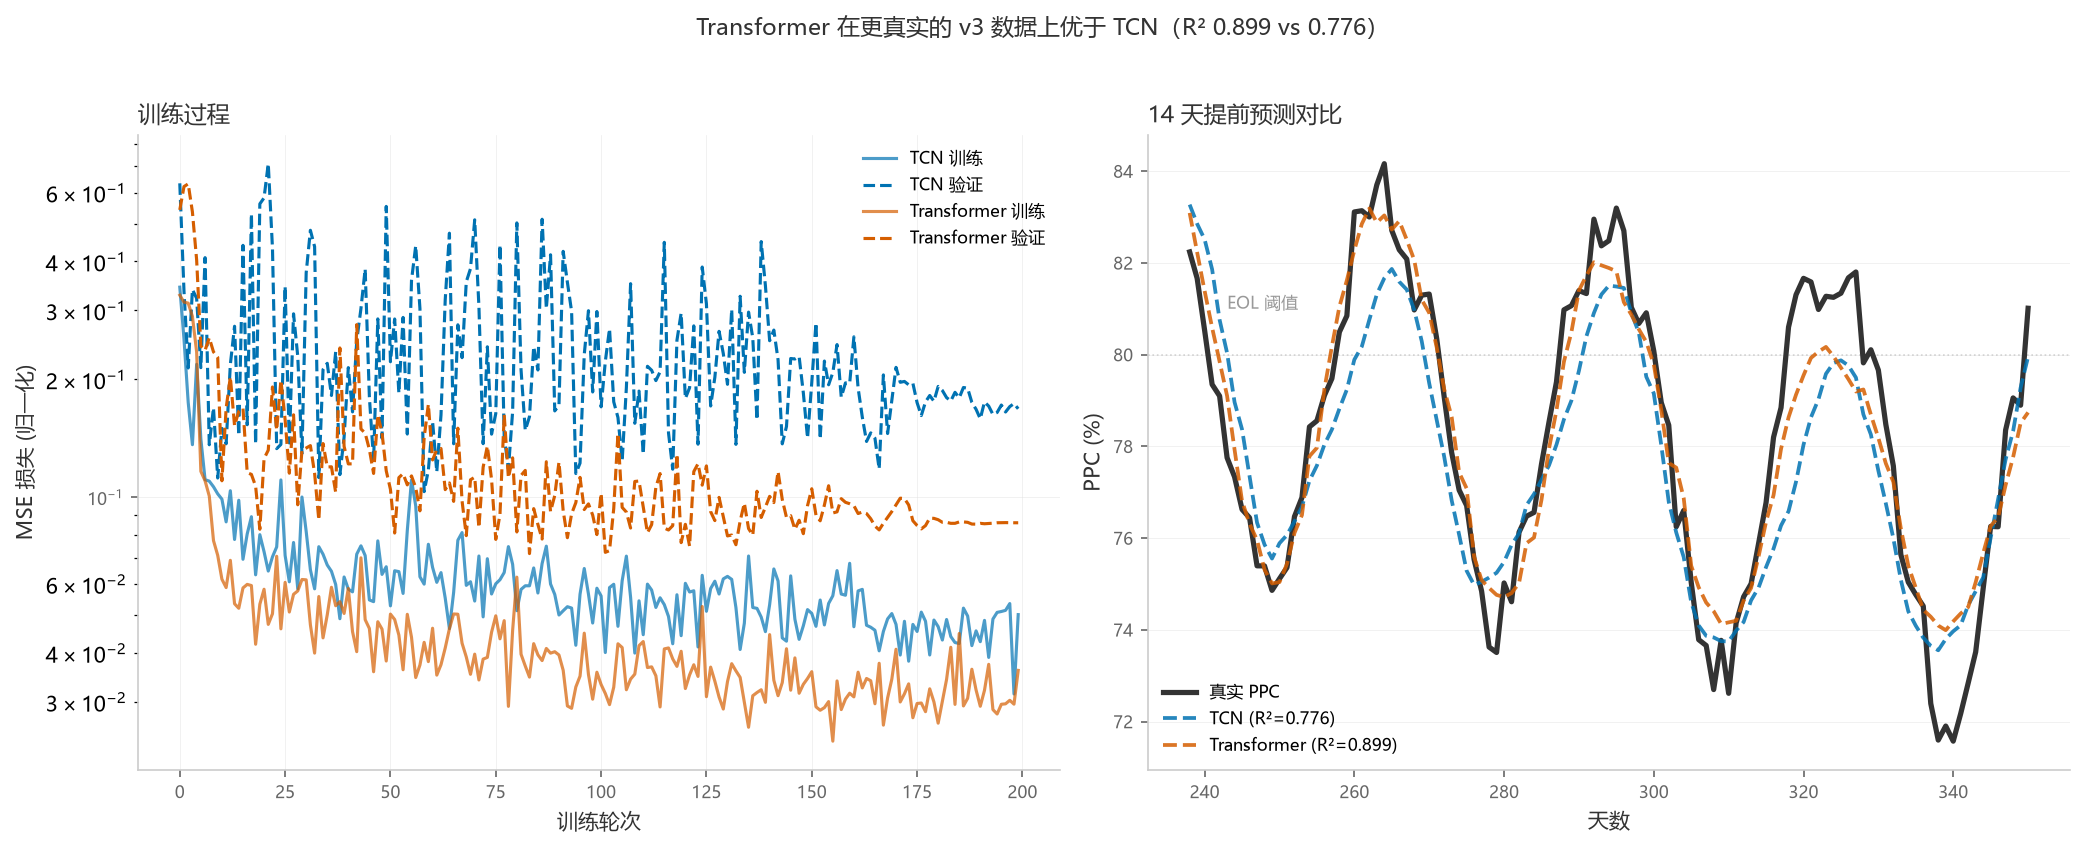
| 指标 | TCN | Transformer | Baseline |
|---|---|---|---|
| R² | 0.776 | 0.899 | -2.553 |
| RMSE | 1.55% | 1.04% | 6.15% |
| 参数量 | 5,729 | 19,265 | — |
| vs Baseline | 降 75% | 降 83% | — |
Transformer 在训练全程保持更低的验证损失,最终预测更贴合真实曲线。TCN 的预测存在明显的滞后和幅度衰减,尤其在波峰附近。
四、为什么 v1 和 v3 结论不同
在 v1 数据(一阶 ECM,无温度效应,容量恒定)上,TCN 达到 R²=0.978,Transformer 优势不可见。这是 R#06 选择纯 TCN 的原因——当时的数据过于简单,不足以区分两种架构。
v3 数据引入了三个复杂度来源:不同活化能的温度波动(R0 受 ±40% 影响,R2 受 ±120% 影响)、二阶极化(短时电荷转移 + 长时扩散)、以及 R0/R1/Q 的耦合但不同步退化。这些多时间尺度的交叉依赖需要自注意力机制来捕捉,膨胀卷积只能处理固定模式。
结论:模型选型不能在理想化数据上做。如果仿真数据过于简单,所有模型看起来都一样好;只有在真实复杂度的数据上,架构差异才显现。
五、特征消融实验
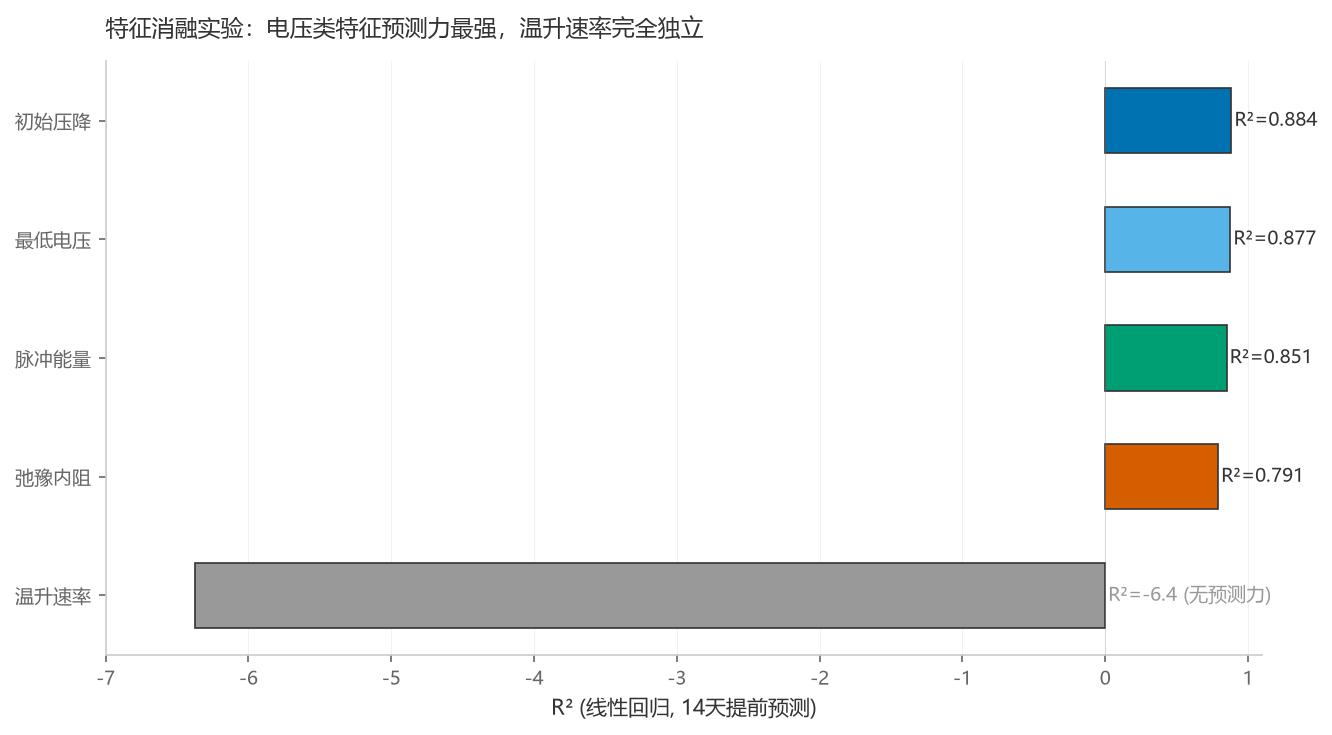
在 v2 数据(引入独立温度变化)上对 5 个特征做消融实验:
| 特征 | R² (线性回归) |
|---|---|
| 初始压降 (voltage_drop) | 0.884 |
| 最低电压 (voltage_min) | 0.877 |
| 脉冲能量 (pulse_energy) | 0.851 |
| 弛豫内阻 (relaxation_ir) | 0.791 |
| 温升速率 (temp_rise_rate) | -6.37 |
电压类特征之间高度相关(都反映 R0 导致的电压压降),这是物理本质决定的。温升速率与 PPC 完全独立(R²=-6.37),但它捕获的是热行为维度,对安全预警有独立价值,对 PPC 预测无直接贡献。全量 20 维特征(R²=0.820)比最佳单特征还差,说明线性回归在高维小样本上过拟合,非线性模型(TCN/Transformer)能更好地利用多特征。
引用来源
- Cell Reports Physical Science (2024)——Transformer 在电池长期退化趋势建模中的先进性。
- IOPscience (2023)——CNN-Transformer-LSTM 混合模型在电池预测中优于单一模型。
- 本系列 Report #02-#03——v3 数据生成与 ECM 参数依据。
登录后可以留言
Peter YU2026/10/16 15:49:25
整体迭代的方向和路径值得“统一封装”一下~