
【研究笔记 07】头脑风暴:RSI的经济帐
Brian · 发布于 2026/10/14 · 更新于 2026/10/14
Brian2026/10/14
Peter的评论把工程能力和投资的不确定性联系在一起,我突然头脑风暴想到一个问题,我能不能把改进能力数学化,模型进化能力是不是可以类比利率之类的数值。纯属头脑风暴,如有错漏,敬请指出。
利率是规定期间内利息与本金的比值,这里借用“相对既有基础改善多少”的想法。利率定义:欧洲央行
能用现有资料算清的是一个更具体的问题:为少做实验而增加的模型调用,是否值得? 下文把一次基线实验成本与一次新增调用均价的比值记为。这个成本比用于算保本门槛,再与论文报告的实验量降幅放在同一笔账里,算出扣除调用费后是否仍然省钱。
先说结论,免得绕远路:电池研发中已有同行评审证据支持闭环实验选择减少部分实验投入。要把这进一步称为RSI,还须证明选择方法本身被修改、继承,并在独立任务上有效。
这篇文章分四部分:先说清AI在BMS研发里到底能碰什么,再把汇率算一遍,再看真实的BMS研发流程里哪些时间真的可以压缩,最后看证据支持到哪一步。
一、AI能碰的和碰不了的
真实的BMS研发是一串物理动作加一串认知动作,混在同一条时间线上:
| 环节 | 主要内容 | AI能做什么 | AI碰不了什么 |
|---|---|---|---|
| 硬件设计 | 电路板设计、器件选型、打样贴片 | 查手册、比对方案、生成检查清单 | 板子要真的做出来 |
| 板级调试 | 上电、测信号、定位故障、改板 | 分析波形与日志、缩小怀疑范围 | 示波器要真的接上去 |
| 底层软件 | 驱动、CAN通信、采样保护 | 生成与审查代码 | — |
| 算法开发 | SOC估计、参数辨识、阈值整定 | 提候选、算残差、做敏感性分析 | — |
| 虚拟标定 | 用仿真代替部分实体测试 | 批量跑参数组合 | 替代比例受模型保真度限制 |
| 台架与HIL | 实测充放电、硬件在环、测试用例 | 设计测试计划、筛掉明显无效的组合 | 设备要真的占用时间 |
| 验证与认证 | 安全标准、型式认证、整包验证 | 整理数据、准备文档 | 排期与样品 |
AI可以辅助判断、分析和计划;电芯充放电、制板与上电则需要真实执行。物理过程不等于工期永远固定:能否减少测试、改变协议或以虚拟验证替代,仍要在相同验收要求下验证。
一个具体的例子:工程师花两天在台架上排查某个工况下估算偏差为什么变大。假设其中一部分时间用于翻日志、对齐时间轴、比对历史批次,另一部分用于改代码和重跑。前者可以尝试自动化,后者也可能因减少返工而缩短。
二、汇率:把"想"和"做"放在一起比
这笔账需要四项输入,后面的计算沿用同一口径:
| 参数 | 定义 | 后文用途 |
|---|---|---|
| X | 基线每次实验的费用,含原有模型调用 | 作为成本比较的基准 |
| c | 每次新增模型调用的平均费用 | 与新增调用次数相乘,计算增量费用 |
| m | 每次实际执行实验对应的新增调用次数 | Rehearse取21,BMS按实际记录 |
| s | 达到同一目标成绩所需的实验总次数减少率 | 代入46%和37%的论文结果,计算是否省钱 |
其中,是每次实验新增的调用费,是实验与调用的成本比。实验总次数应包含执行后未带来改进的尝试,调用费也要包含重试;如果各次实验成本差异很大,就应逐笔汇总,不能套用单位费用不变的简式。
Rehearse每步新增20次评判和1次候选生成。沿用本文Claude Sonnet 5.5标准价及设定token量的费用情景,一次评判约0.005至0.03美元,一次候选生成约0.02至0.15美元,因此、约0.12至0.75美元,即0.86至5.4元。协议均价约为0.04至0.26元/次。调用数量来自论文,金额是条件测算,不是论文实测账单。Rehearse附录B、Claude官方价格
作为对照,本文费用情景取工程师每小时178至273元、一次2小时电芯工况测试109至979元;后者由物料、台架与工时拼合。覆盖一步新增调用费,需要节省约0.2至1.8分钟人工时间:分别按“0.86÷273×60”和“5.4÷178×60”计算。这是工时门槛;只有实际减少支出或释放了可用产能,才有对应价值。
把电芯实验费用除以协议调用均价,成本比约为424至23,788。图1同时给出其他场景的成本比,供下一步代入保本计算;费用区间使用未四舍五入的输入。
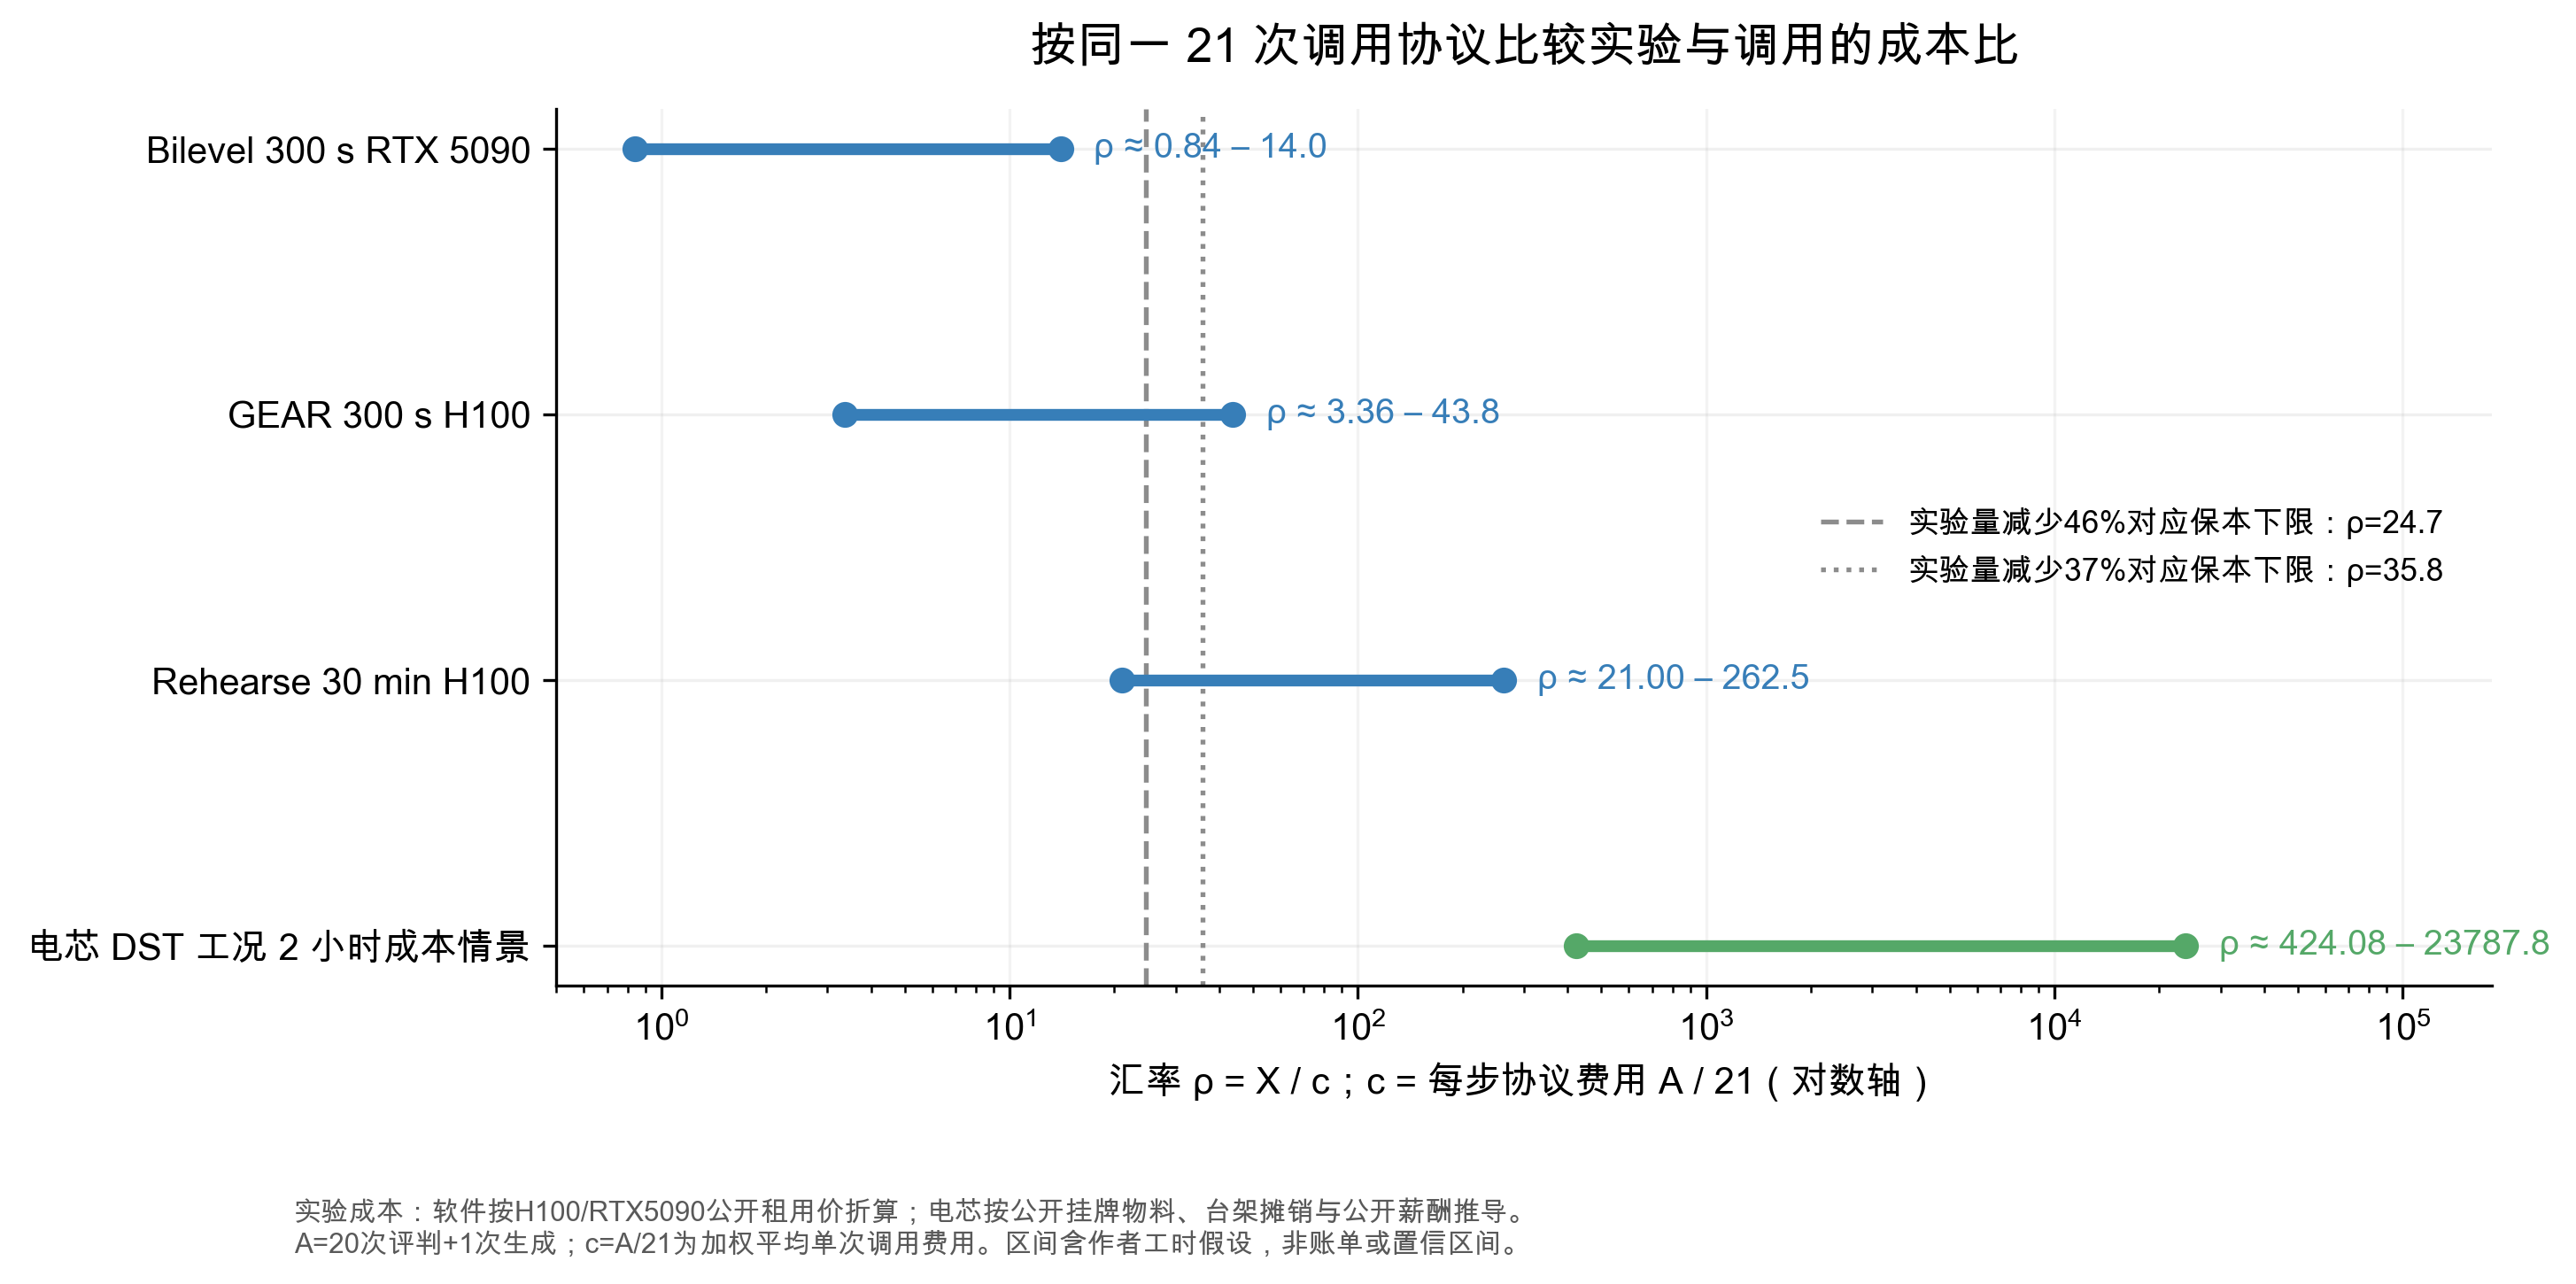
图1。各场景的条件成本比。单次调用采用同一个21次协议的均价;Rehearse场景为21至262.5,电芯DST场景为424至23,788。区间来自费用情景,不是论文实测账单或统计置信区间。
实验次数减少后,剩余次数是基线的,但每次都要多付调用费。在目标成绩相同、单位实验成本不变且暂不计固定投入时,保本要求是,由此得到最低实验节省率:
这个公式直接用于图2。代入21次新增调用,Rehearse费用情景对应的保本门槛为7.41%至50%;电芯DST费用情景对应0.09%至4.72%。这些门槛只覆盖模型新增调用,接入、人工复核和维护会进一步提高所需节省。
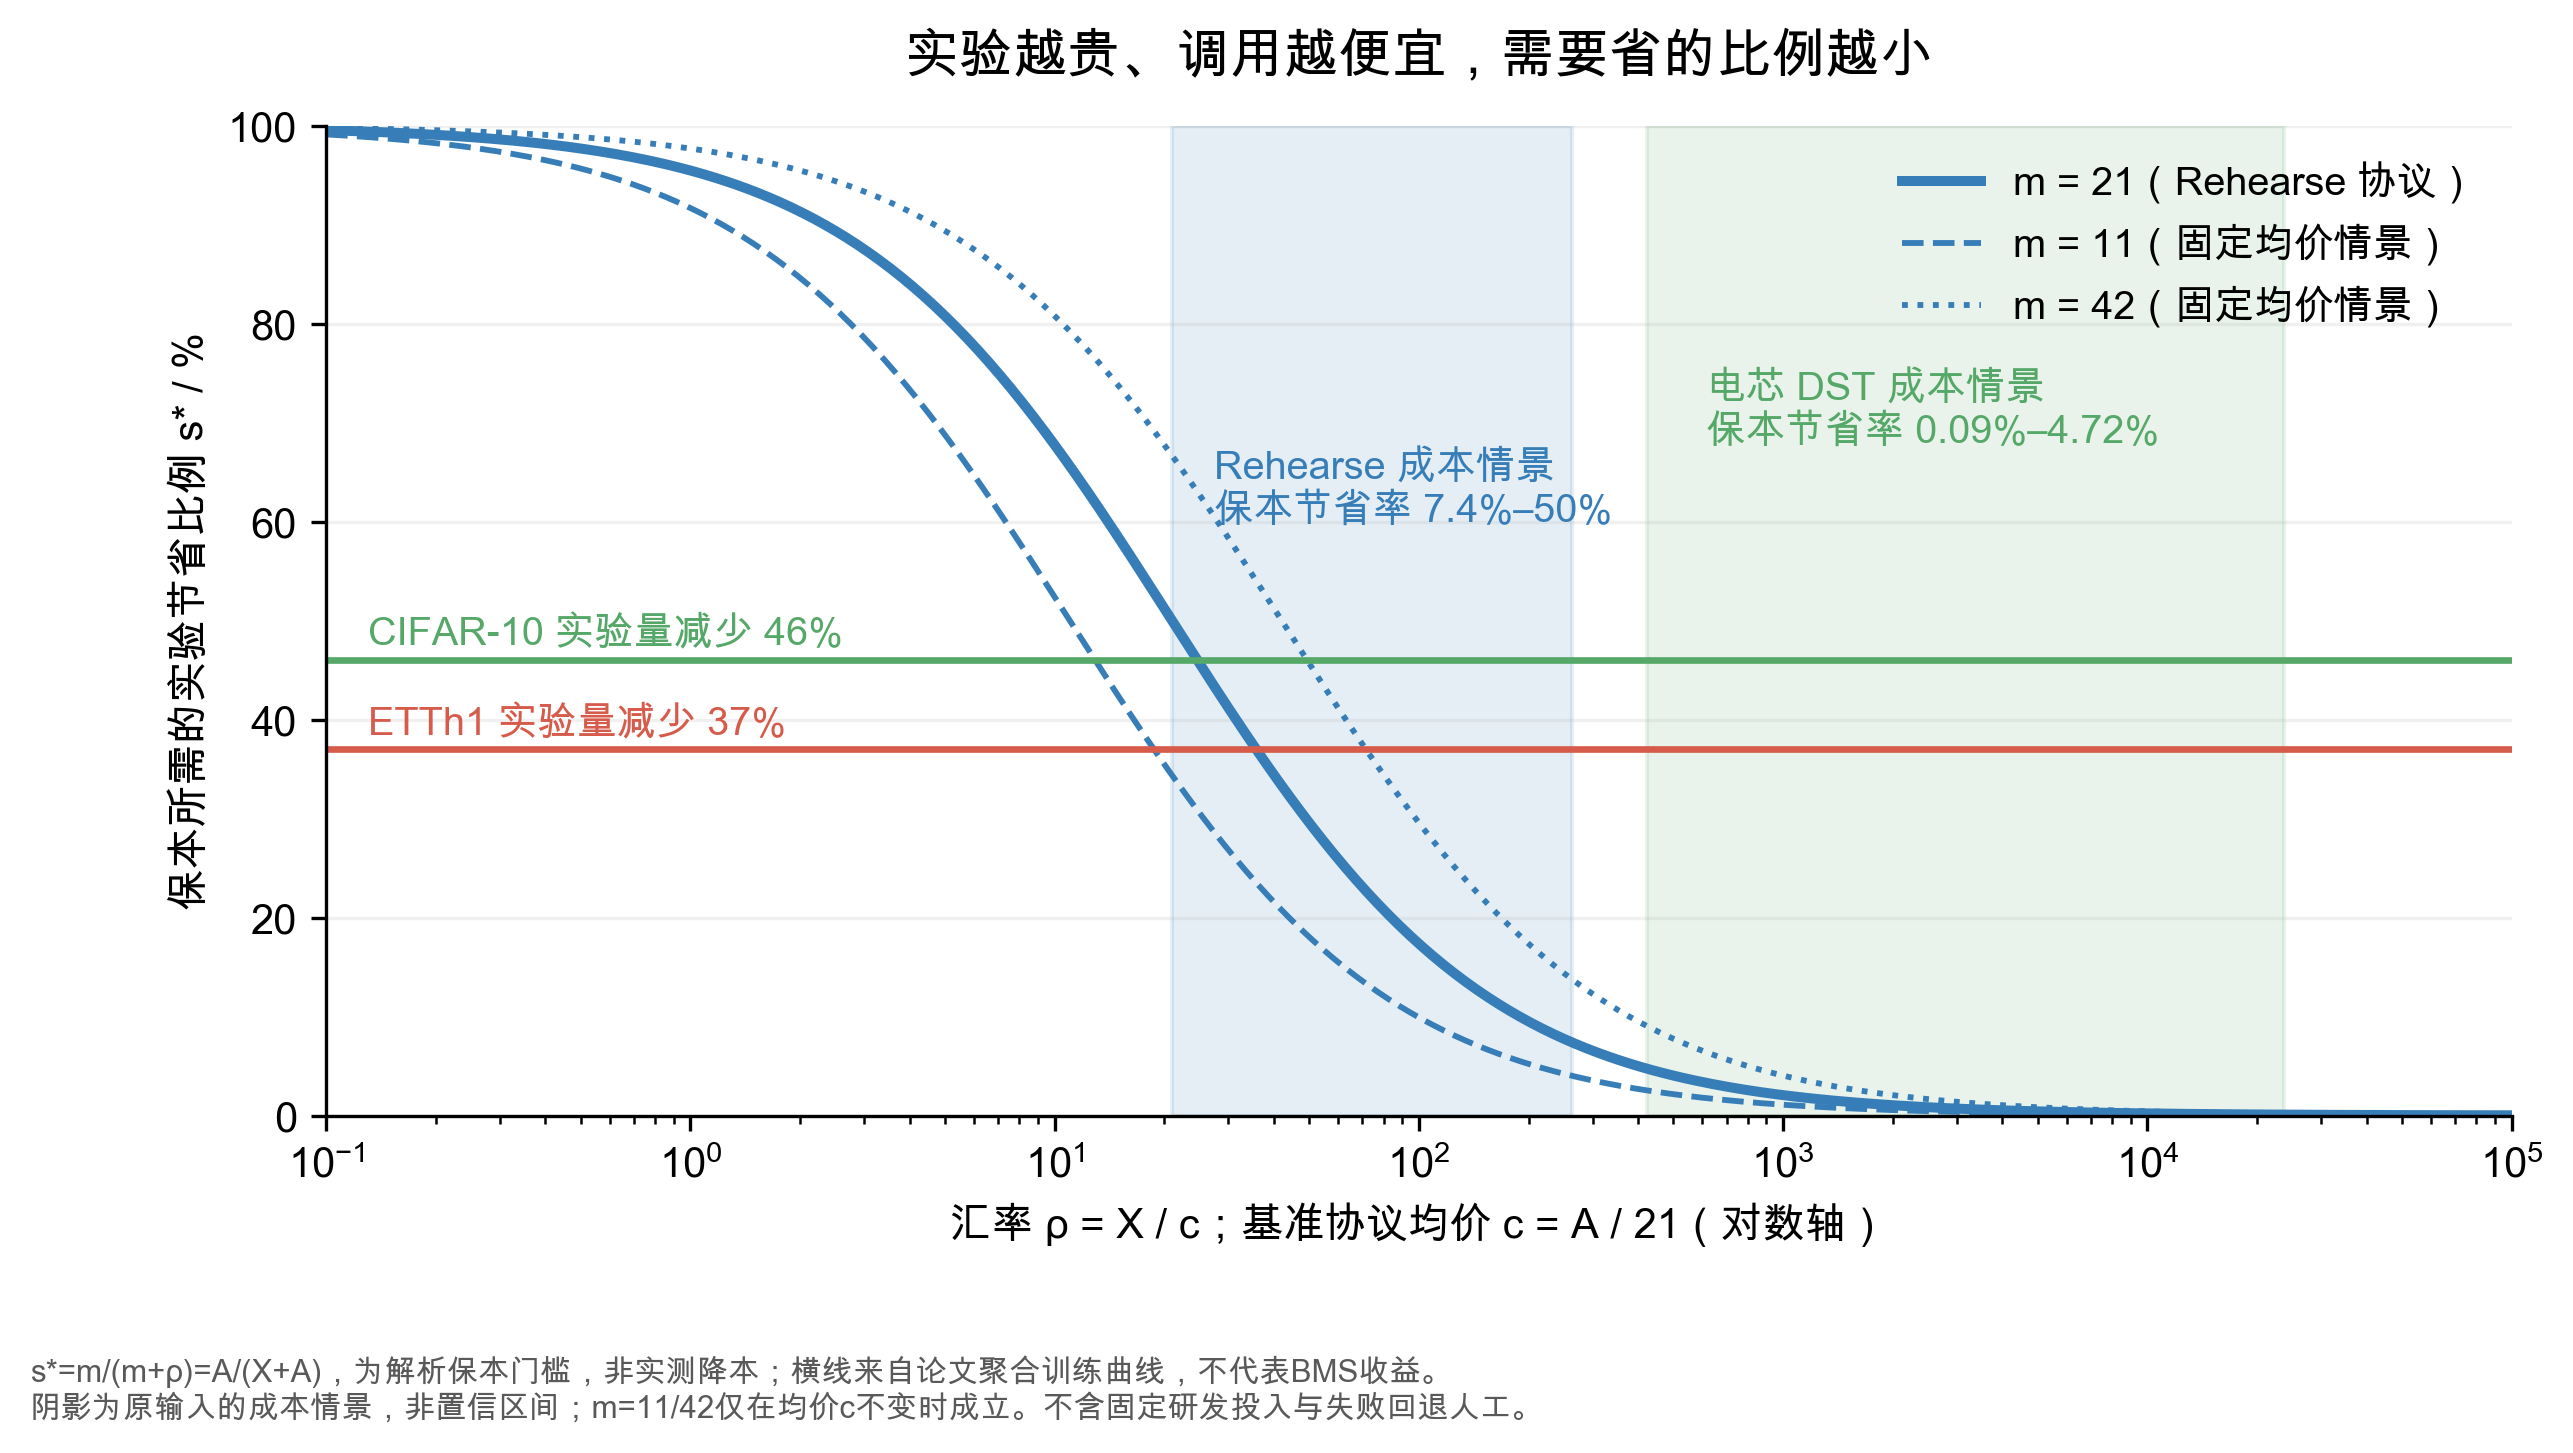
图2。横轴是成本比,纵轴是保本所需的实验节省率;两条横线为Rehearse报告的46%和37%。实验节省率高于曲线,才足以覆盖这个模型里的新增调用费。曲线是解析关系,不是实测BMS降本轨迹。
再把“需要省多少”落到“扣完调用费还剩多少”。 Rehearse的聚合曲线达到普通循环第100次实验的终点成绩时,分别用了54次和63次,即实验总次数减少46%和37%。沿用相同费用假设,净可变成本节省率为:
它的分母是基线实验总费用:100次基线花费100X;改进后54次或63次,每次花费X+A。将论文报告的次数降幅与图1的Rehearse费用情景两端配对,得到:
| 论文报告的实验量变化 | 成本比ρ=21 | 成本比ρ=262.5 |
|---|---|---|
| CIFAR-10:100次降至54次,减少46% | −8.00%,费用增加 | +41.68%,费用减少 |
| ETTh1:100次降至63次,减少37% | −26.00%,费用增加 | +31.96%,费用减少 |
以第一格为例:1−(1−0.46)×(1+21÷21)=−0.08。实验少做46%,但每次新增调用费恰好等于基线实验费,最终仍多花8%。 这就是为什么不能把实验减少率直接写成降本率。实验次数来源:Rehearse第5.3节
表中是“公开实验次数+费用情景”的条件计算,尚未扣除接入、人工复核、维护等费用;它不是论文实测收益率,也不是BMS收益预测。54次和63次来自聚合曲线,不代表每条轨迹都能按这一轮次停止。
三、最有价值的能力:决定下一个实验做什么
汇率有利,但还要看AI实际能做到什么。这里有一份电池快充实验设计的同行评审证据,可供BMS研发方法设计参考。
Attia等人在Nature上报告了用闭环贝叶斯优化寻找快充协议的工作:在224个候选协议中,用16天找到高循环寿命的协议,而穷举搜索需要超过500天,测试时间减少约98%,相对随机搜索约15倍加速。117个协议从未被测试过。Attia et al., Nature 578, 397–402 (2020)
这个结果容易被误读。它不是"模型算出了正确答案",而是"模型决定了下一个实验做什么"。同一工作中,早期预测模型用前100圈的退化特征预测最终寿命(误差约9%),从而免去了把电池跑到失效。两件事合起来才是完整的机制:
- 预测压缩了单次实验的时长(不用跑到失效);
- 选择压缩了实验的次数(不做没信息量的组合)。
这正是我上一条说的"认知环节"在电池上的具体形态。 也解释了为什么这类方法的报告方式是"减少了多少次实验",而不是"算得更准"。
同样的模式在其他物理实验里重复出现:机器人平台Clio用40次实验在15次内收敛到电导率最优点(离散候选空间超过1000个点);芝加哥大学的主动学习工作从58个种子数据点起步,经七轮、约70次实验,筛出4种性能可比当前最优的溶剂。Clio、UChicago
为什么"选下一个实验做什么"这么值钱? 因为电芯参数辨识本身是不适定的。同一批数据、两种经典算法(信赖域与Levenberg-Marquardt),拟合优度都在16 mV以内,但同一个电阻参数的估计值平均相差89.99%,另一个电阻相差376.74%。原因是等效电路模型的参数跨越约10⁴个数量级(毫欧级电阻与千法级电容并存),Hessian矩阵条件数可达约10⁸。Scientific Reports 2026
这意味着一组"拟合得很好"的参数,可能根本不是唯一解。 在这种情况下,实验设计的价值不在于算得更准,而在于用最少的实验把参数空间约束到唯一。这正是AI能起作用的地方,也正是它不能替代实验的原因——约束只能靠新数据获得。
四、日历时间里有多少是可决策的
上一节说的是"减少实验次数"。还有一笔账容易被忽略:实验排程本身。
Chalmers的一项实测很说明问题。同一批电芯跑满4,000次循环,如果每50次循环做一次完整的参考性能测试,总日历时间是400天;如果改成每200次做一次,只要228天。被测的东西完全一样,差172天,约43%。Chalmers, Measurement: Energy 4 (2024) 100019
同一份研究还记录了另一类浪费:因为实验室无法24小时值守、测试软件不支持序列编排,每一次测试都必须手动启动,导致电芯在两次测试之间累计闲置42天和31天(其中6天是仪器意外停机)。
这172天不是物理约束,是决策。 什么时候做参考测试、怎么排测试顺序、哪些组合先做——这些是可以在实验开始前算清楚的。AI在这里的作用不是更快地算,而是把这类组合问题处理得比人工排班更系统。
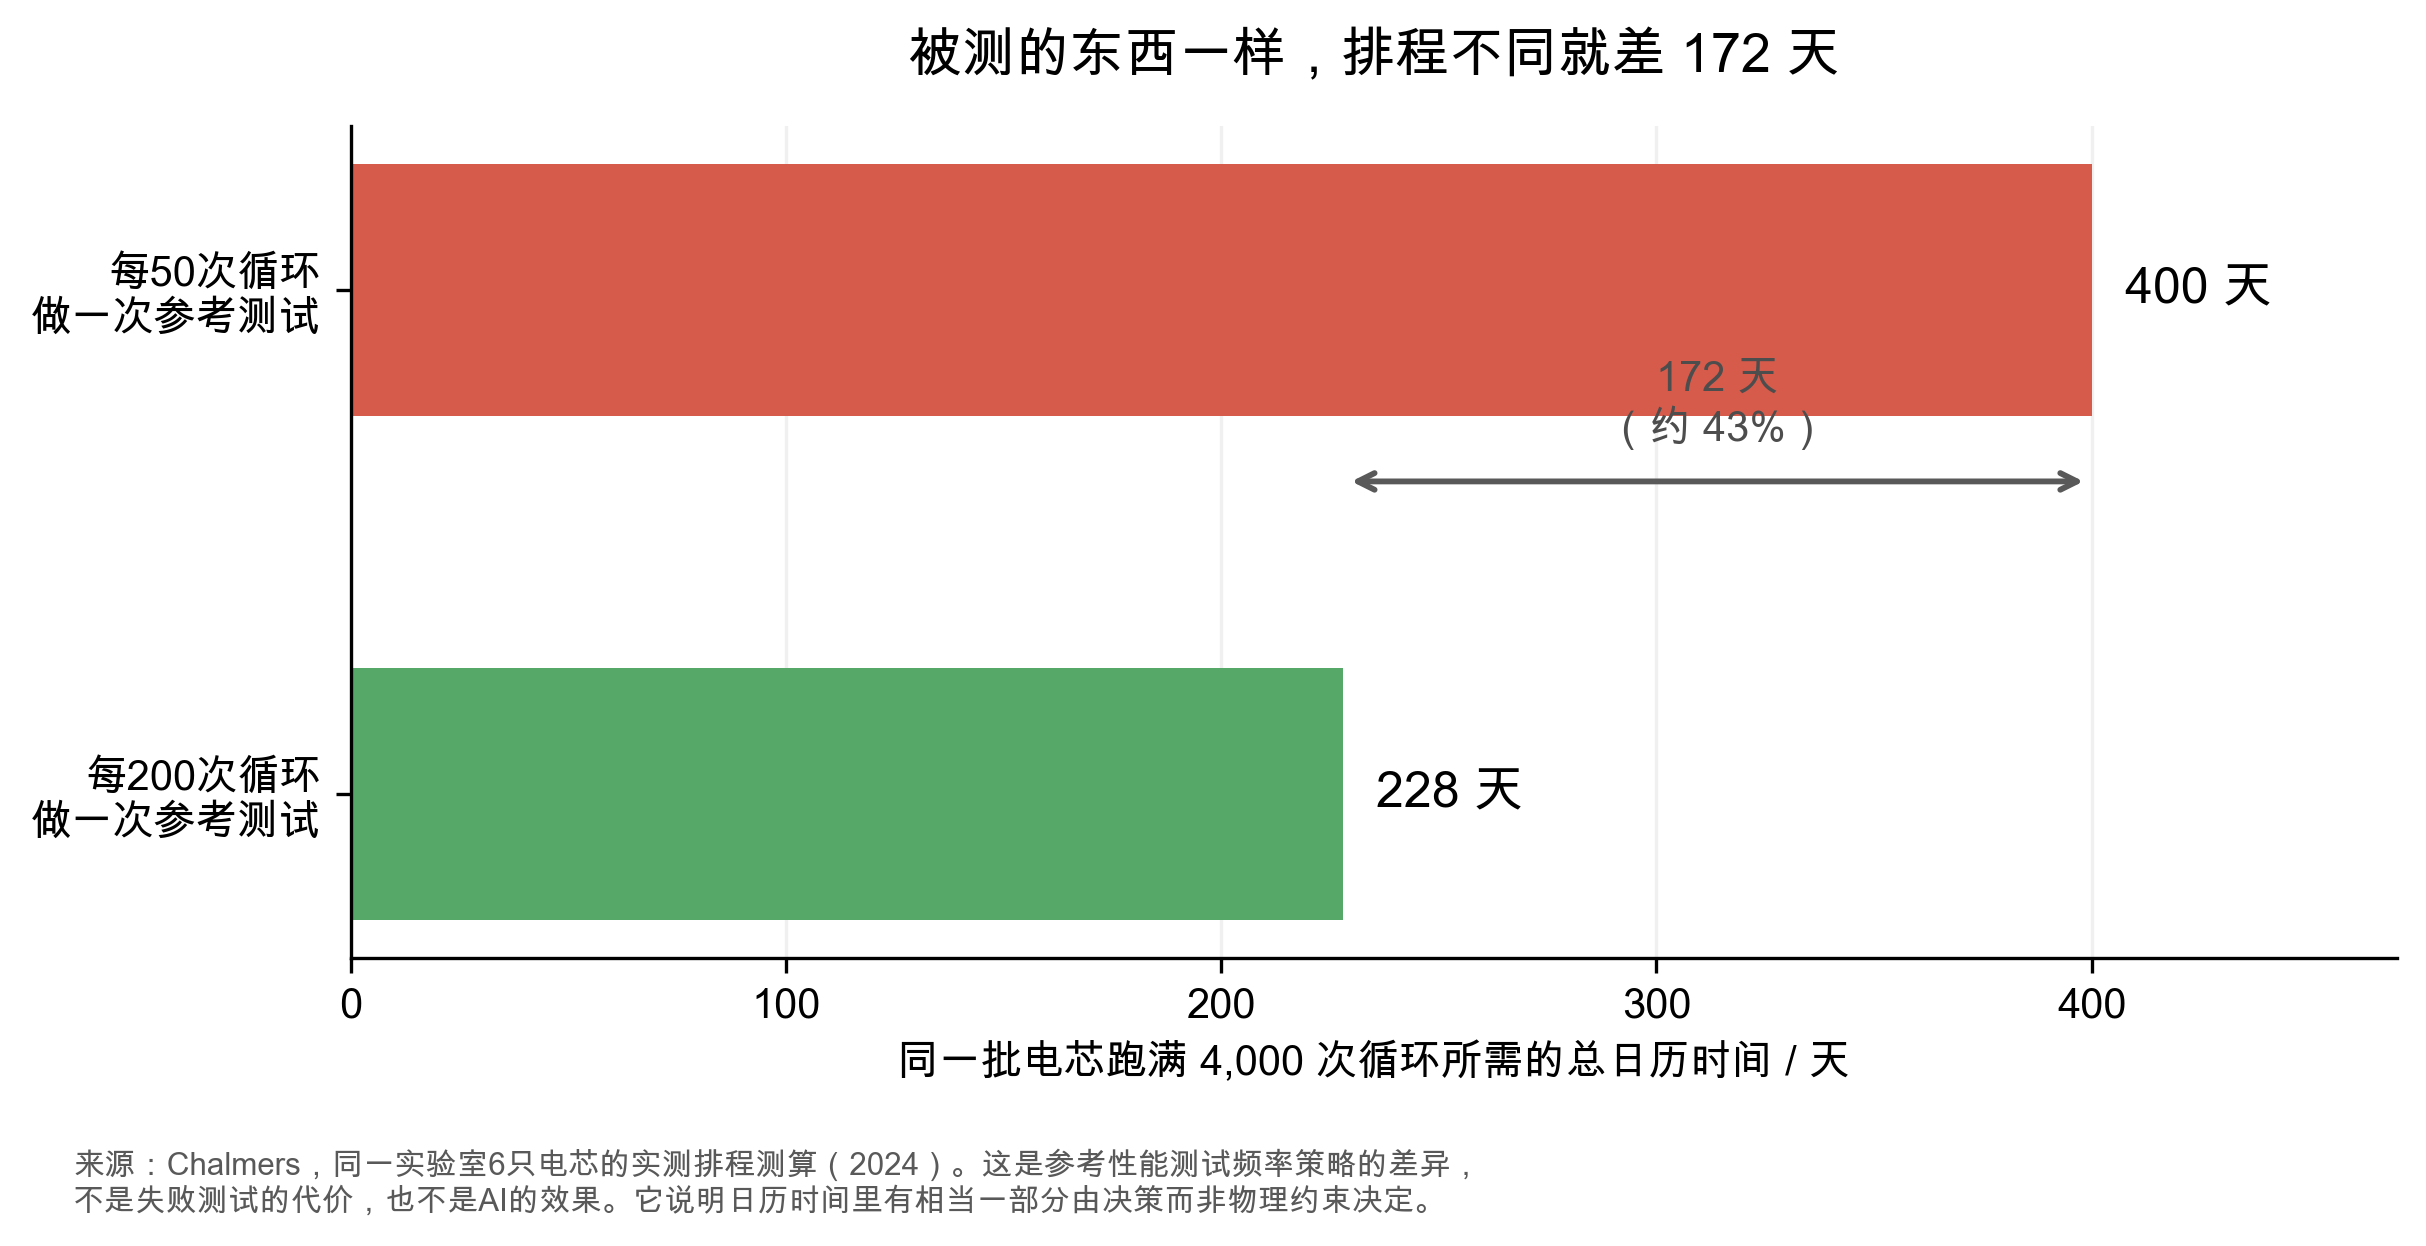
图3。同一批电芯、同样的物理测试,仅因参考测试频率不同相差172天。这不是AI的效果,也不是失败测试的代价;它说明日历时间里有一部分由决策而非物理决定。
不过,现有流程中耗时最长的部分,不能直接判定为不可优化。 FormEL资料中的EOL指End-of-Line,即产线末端质量测试。报告记载参考流程总计约31天,自放电测试约28天,容量与脉冲内阻测量约2天;这些近似数没有闭合,不能把差额补成“3天实测”。该项目本身就在研究合并formation与EOL步骤、缩短流程并保持质量判断能力,资料没有给出AI或RSI的节省率。TU Braunschweig / elenia 2021年报,第38页
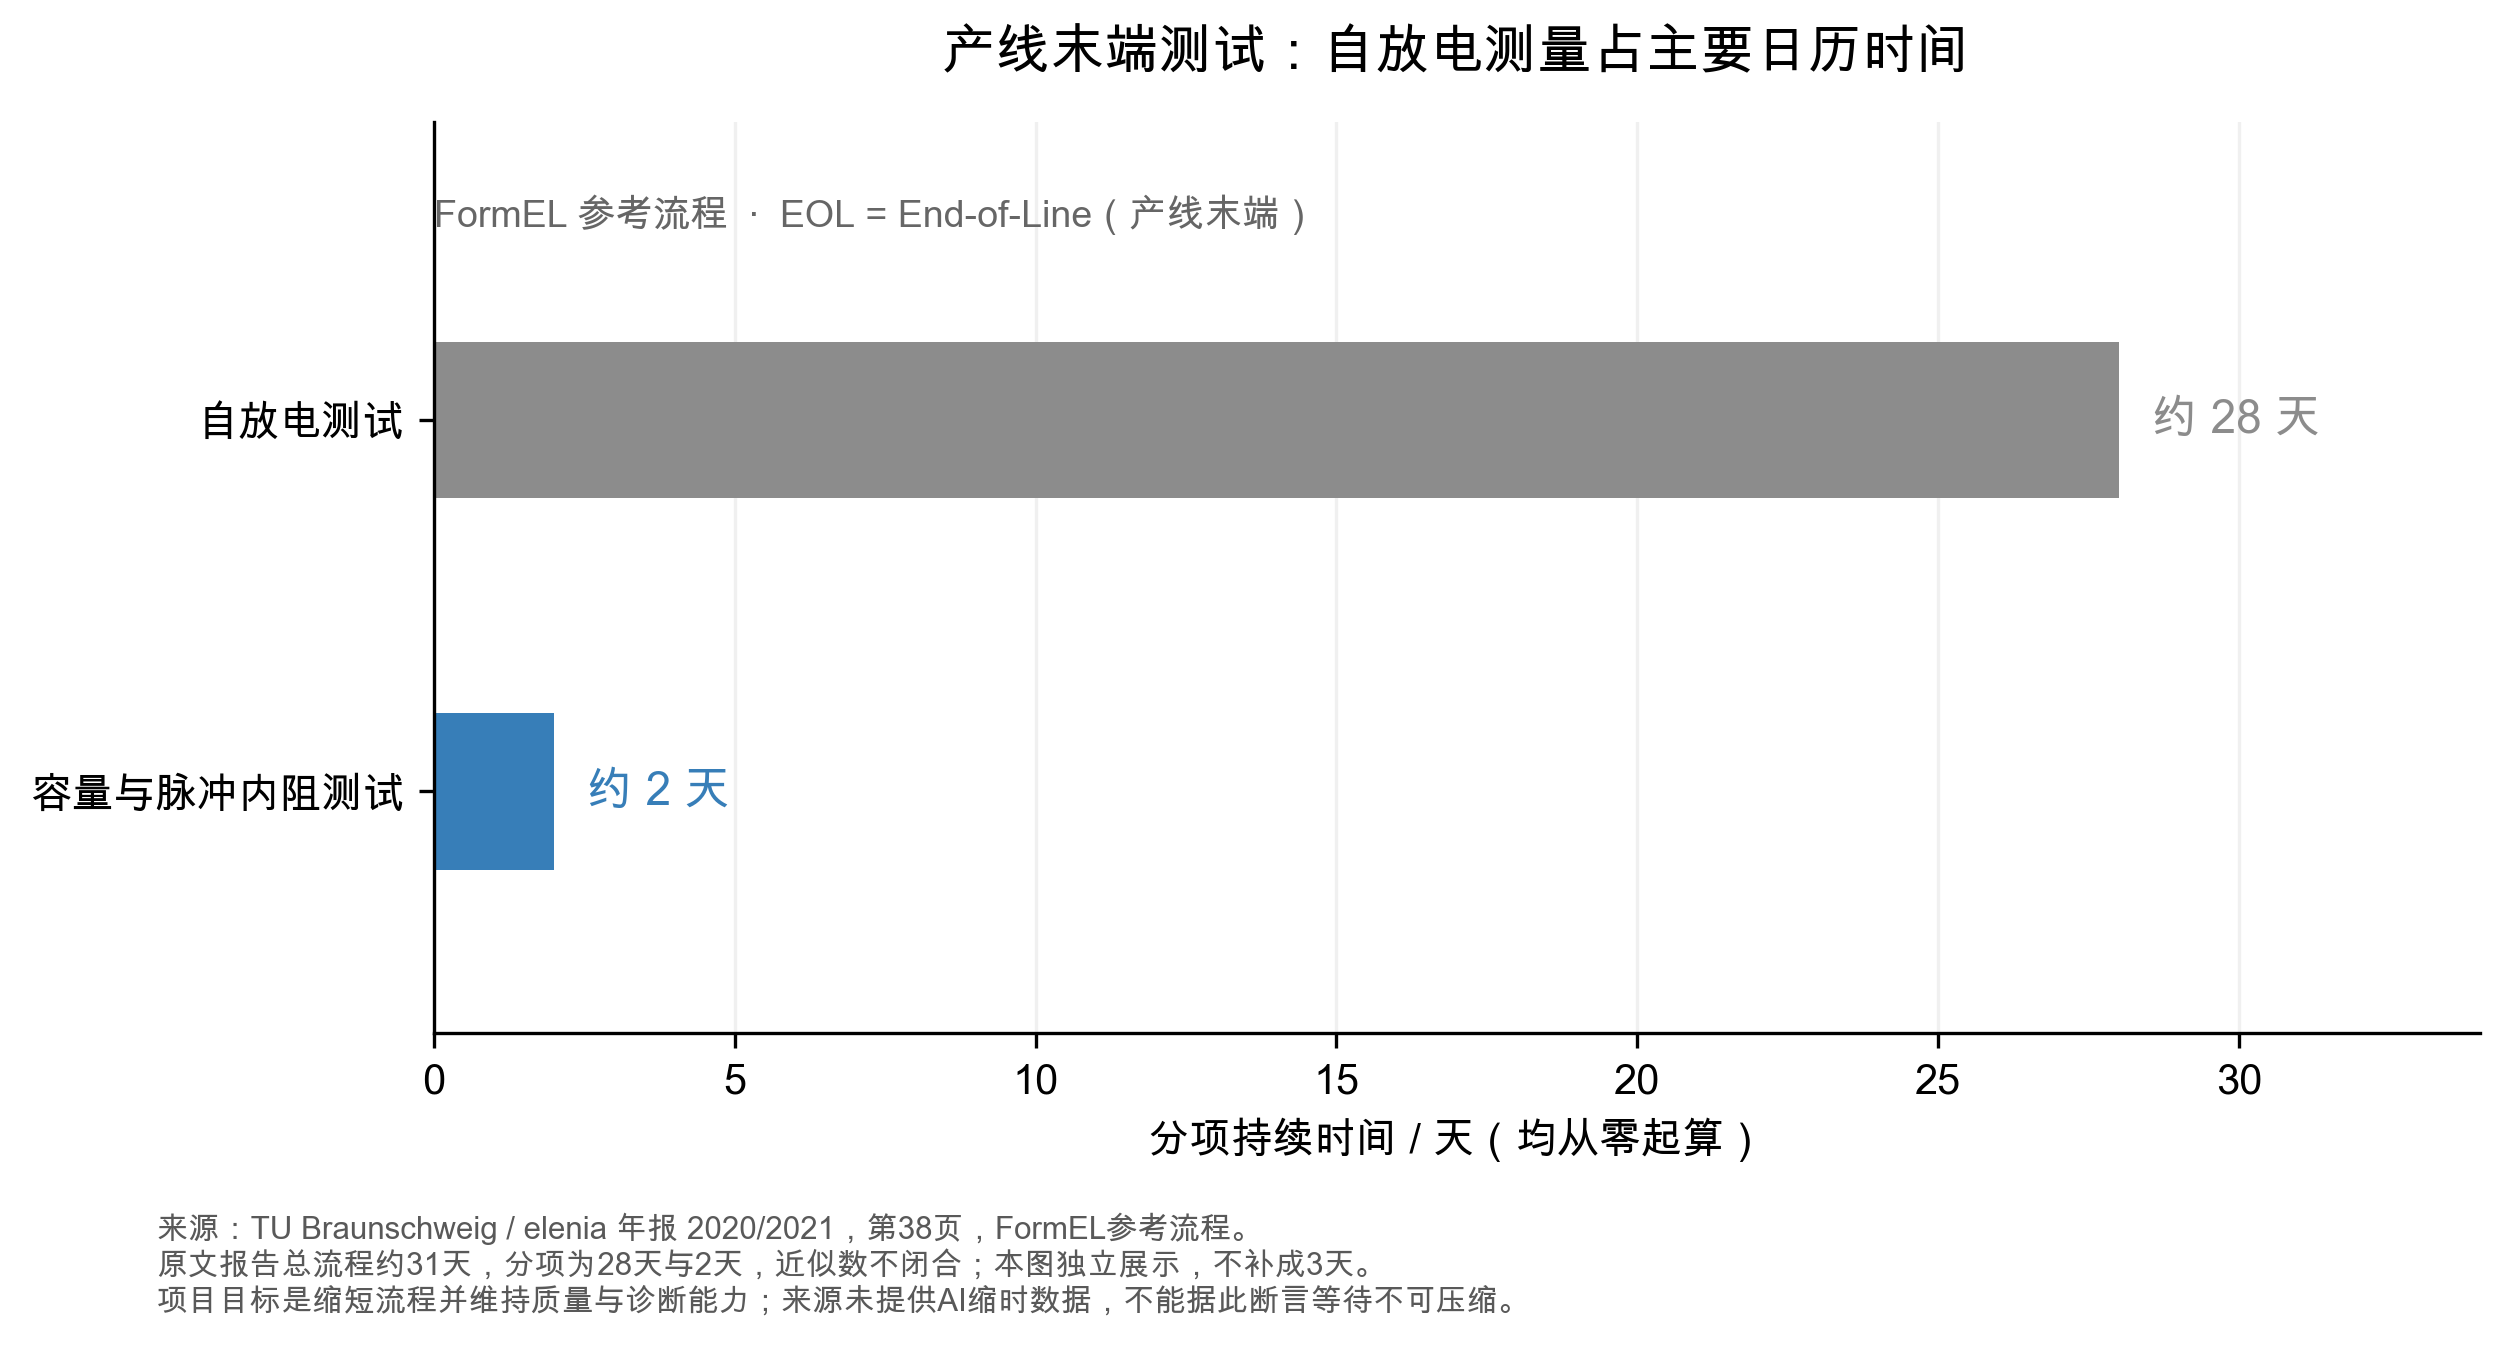
图4。分别展示原文报告的约28天与约2天参考流程的耗时。
这些资料支持把排程、组合选择、参考测试频率、流程衔接与测试协议分别记账。是否能缩短静置、循环或主动测量,要在质量判定与安全要求不变时验证,不能仅凭耗时构成图决定。 AVL的实验室管理白皮书也提到,测试实验室的设备综合效率(OEE)常常"只是其能力的30%",原因明确列出了闲置与空置通道、以及"因测试需求不明确导致的测试重复"。AVL Lab Management白皮书
五、真实的BMS研发流程长什么样
前面几节用的是别人论文里的实验。这一节把镜头拉回到BMS研发本身,看真实的项目由什么组成、钱和时间花在哪里。
先看一份车规级ECU定制开发报价的分项:人力约50%,工程费用约33%,测试约10%,模具约3%。这是单一ECU报价,不能据此认定所有BMS项目的人力占比,也不能把“工程费用”直接等同于物料与设备费用。ECU开发成本结构
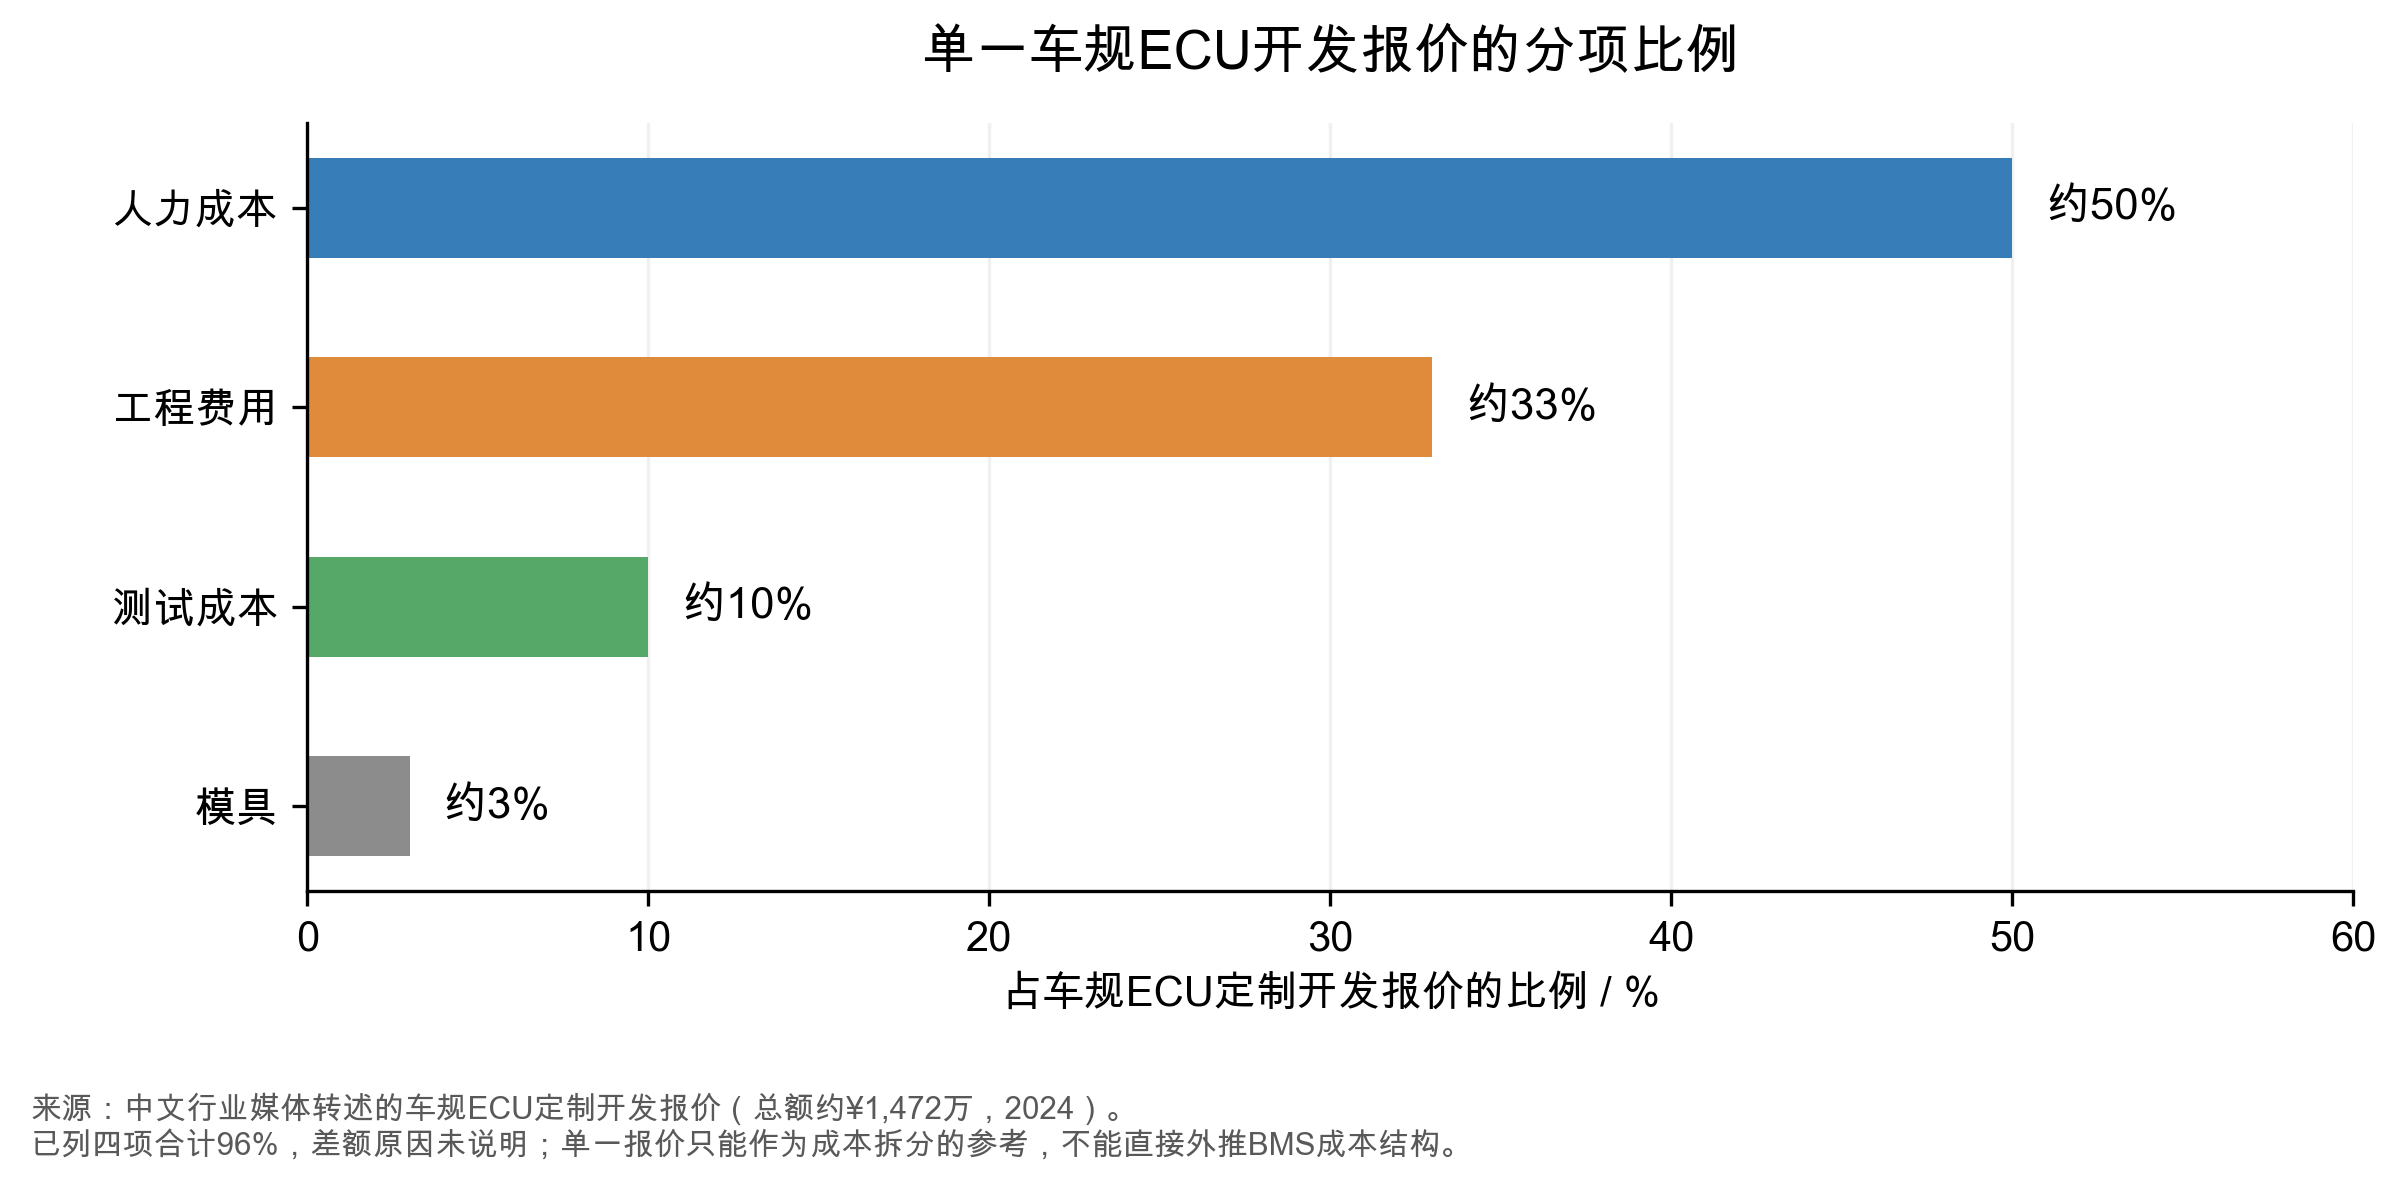
图5。单一车规ECU报价的四个已列分项,合计96%;差额原因未说明。
这提示我,BMS经济核算需要同时记录人力与设备,不能预先认定哪一项最贵。只有拆开本项目的实际账单,才能判断搜索、分析和复核环节的改善究竟影响多大成本。
再看一份逐阶段列出典型耗时的公开资料。它面向通用电子产品,下面选取与BMS硬件研发相关的阶段作参考:Projects House原表。
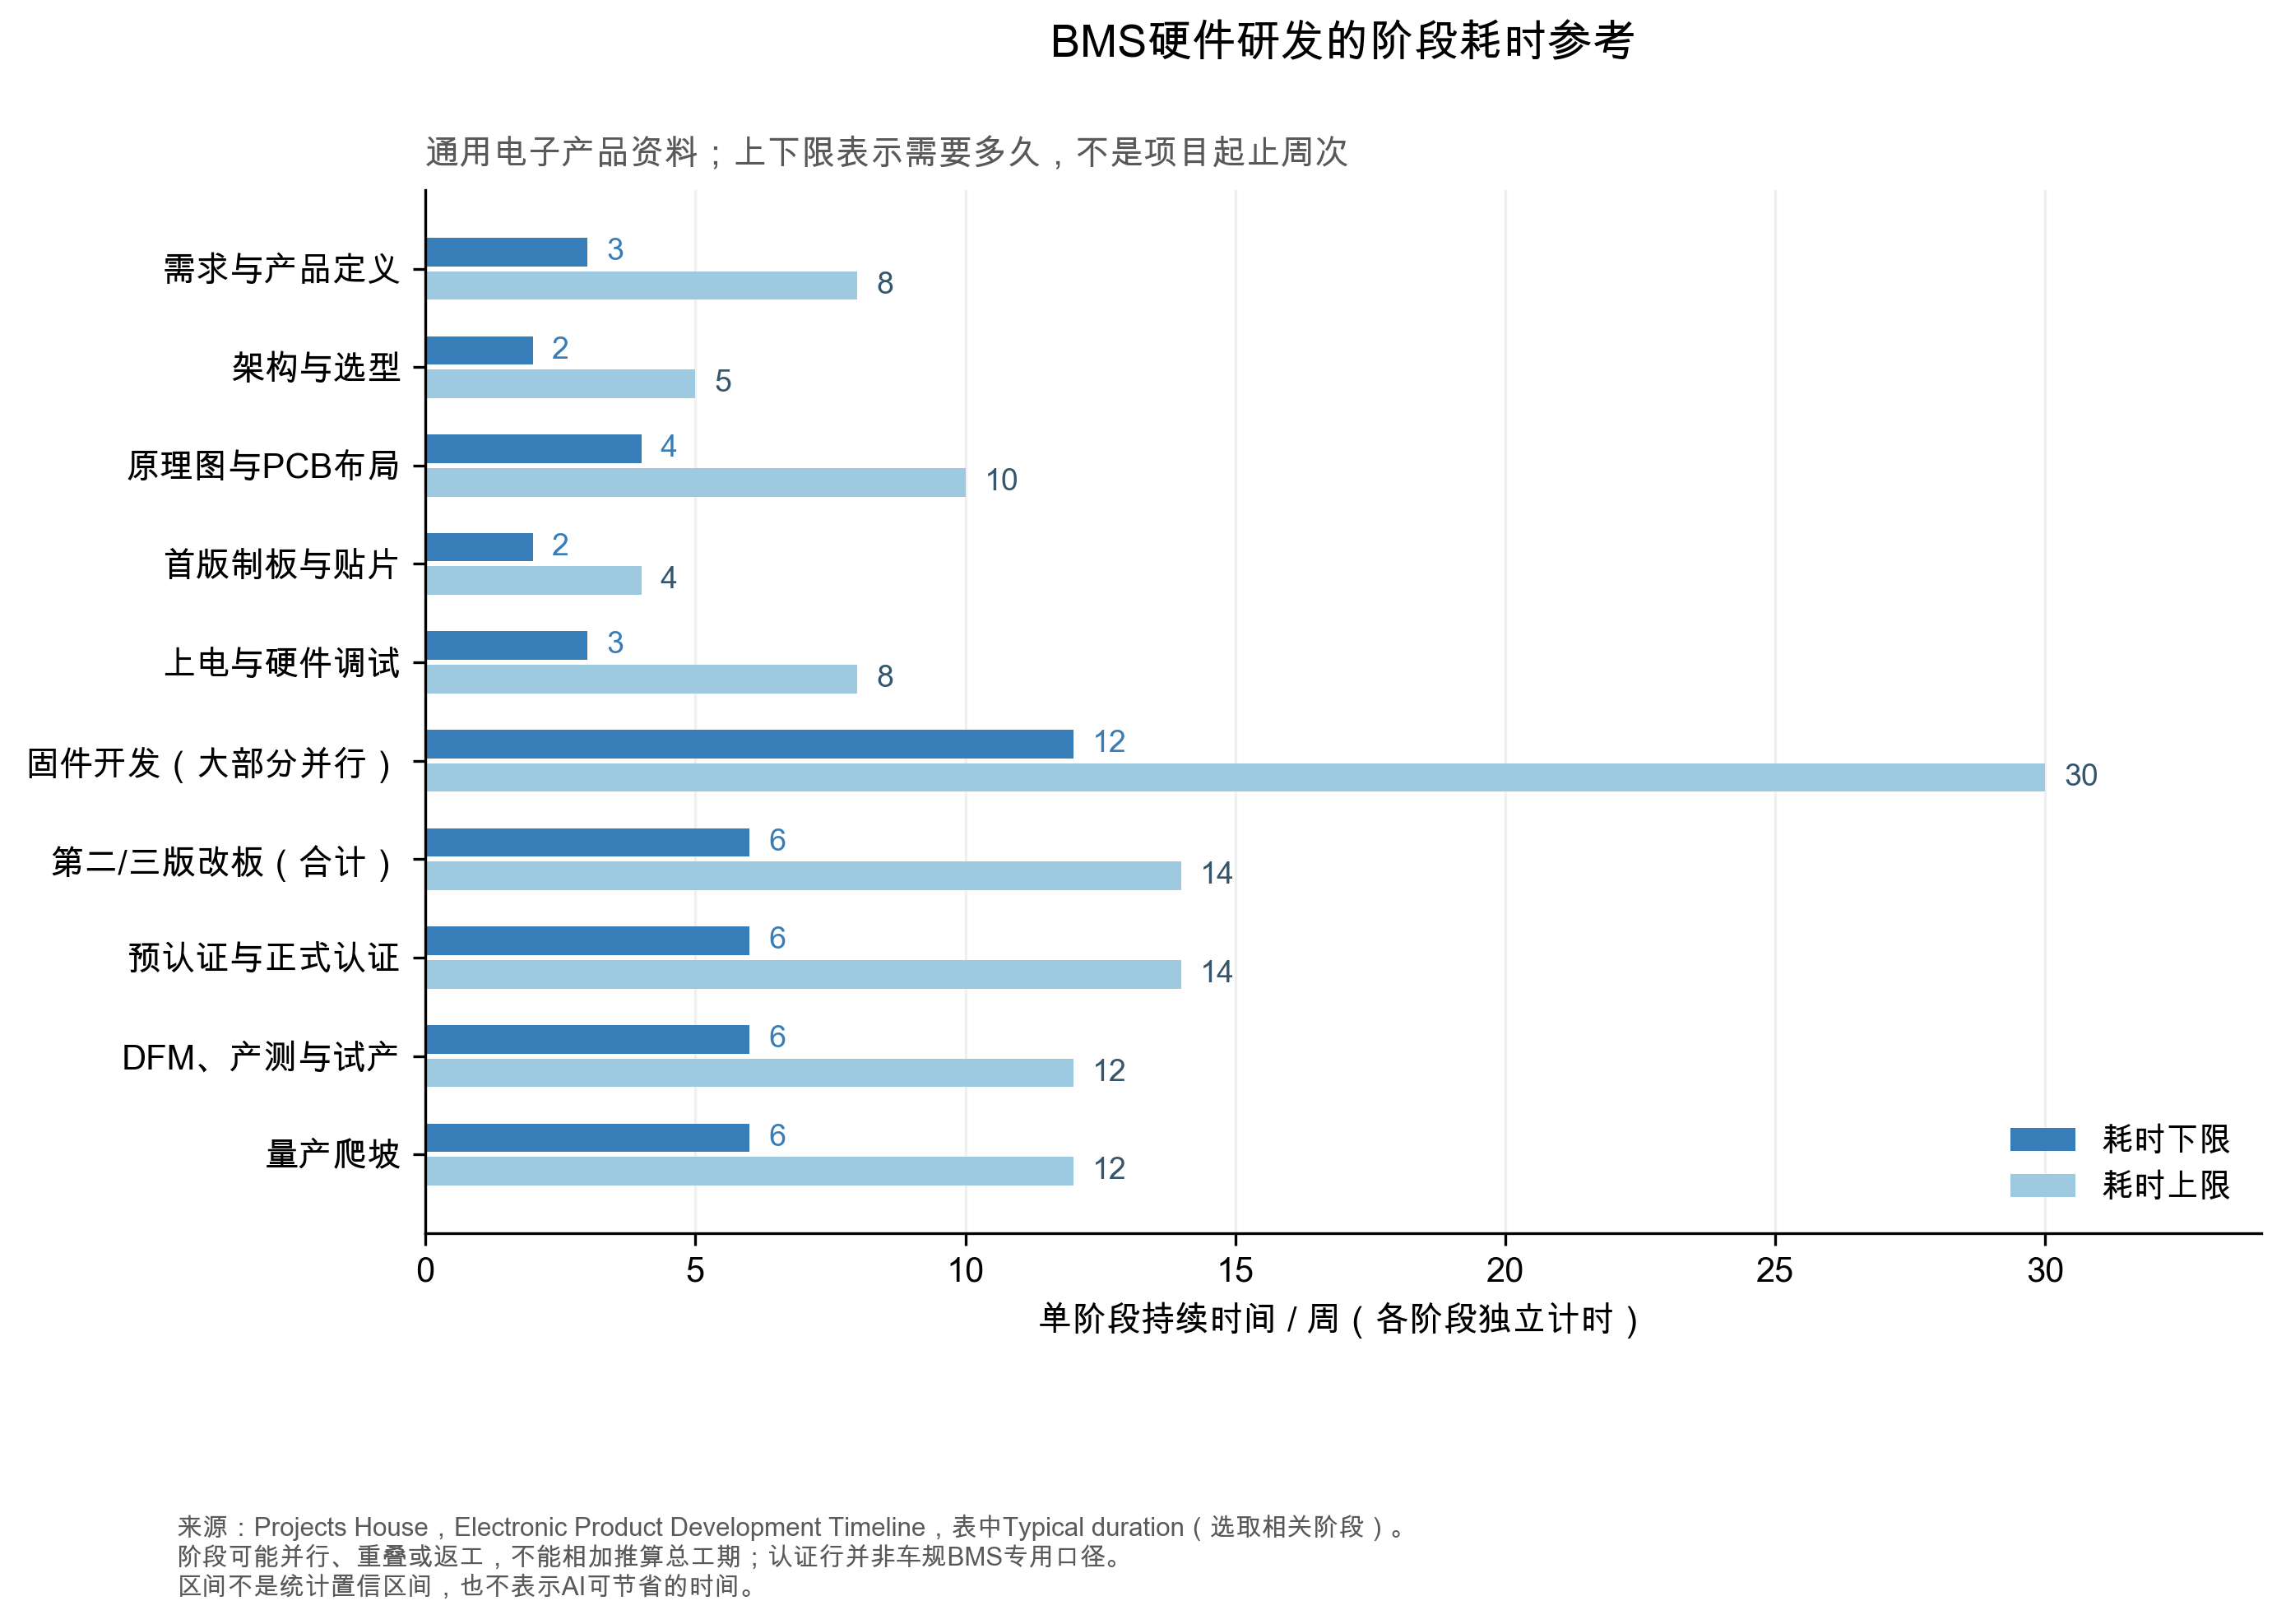
图6。两根柱分别从零起算,表示每阶段典型耗时的下限与上限。例如3–8周是需要3到8周,不是第3周开工、第8周完工。原资料为商业服务商的通用电子产品经验,非BMS实测;认证行也不是车规BMS专用口径。阶段可并行或重叠。
其中上电与硬件调试要3至8周,而改板后的上电与测试仍需2至6周,另有约1周布局修改和1至2周制板装配。这一段的性质很特别:它既不是纯粹的物理过程(板子已经在了),也不是纯粹的脑力劳动——它在物理设备上做诊断。有行业描述说"上电调试往往比设计本身更久"。
算法标定这一段,情况更清楚。 一份真实的108串磷酸铁锂公交电池包的EKF调试记录显示,从第一版到第三版共修掉7个bug,而其中三个是典型的"参数与配置错误":
- 串联数写成120而实际是108,使OCV表放大11%,造成约+3%的系统性SOC偏差;
- 容量按105 Ah假设而实际约89 Ah,安时积分低估放电量18%;
- 优化在72,000个点上运行,循环内的插值调用达到约1,000万次,跑了两小时以上还没收敛。
修完后SOC估计的RMSE从3.82%降到1.5%以内,优化运行时间从约2小时降到约3分钟。案例来源
这个案例要谨慎引用——它是个人项目,非同行评审,仓库没有关注者,作者自述参考SOC只是1%步进的阶梯值、并非真值。但它的结构很有代表性:错误的来源不是物理世界的不可预测,而是人为的参数与配置失误。 这类错误正好落在认知通道里:AI可以核对串联数与实际配置是否一致、可以比对容量假设与实测值、可以把两小时的穷举优化换成有引导的搜索。而它修不了的,是电池本身。
现场还有一类被普遍提到的瓶颈:HIL台架是串行排队的。 集成测试要在共享的HIL台架上排队执行,这正是厂商转向虚拟测试的公开原因。台架数量有限、测试要排队,意味着"少做一个无效用例"的价值不只是省电费,而是把队列让出来。
六、但证据本身有系统性的问题
这一节可能是全文对投资人最有用的一段。
第一,报告缺失。 一项对111个自驱动实验室研究的综述发现,只有40%报告了任何直接的性能基准测试。另一项统计了237项AI分子半导体研究,仅38项报告了实验验证,46篇生成式设计论文中只有5篇做了合成或器件级评估。该综述的原话是:没有任何一项研究报告了失败合成或失败实验的系统性统计,负面结果的缺失使成功率的定量评估无法进行。自驱动实验室基准、分子半导体综述
按这个标准,我前面引的Attia、Clio、UChicago三条之所以能用,恰恰因为它们是少数报告了基线对照的。
第二,"体感省时"与"实测省时"会背离。 METR做过一次罕见的对照:16名资深开源开发者在他们熟悉的成熟代码库上完成246个真实issue。结果是——事前预期快24%,事后自评快20%,实测慢了19%。 METR
同一份研究的条件很特殊(10年以上经验、百万行级仓库),不能推广成"AI普遍拖慢"。但它说明一件事:自评的时间节省不能当核算依据。
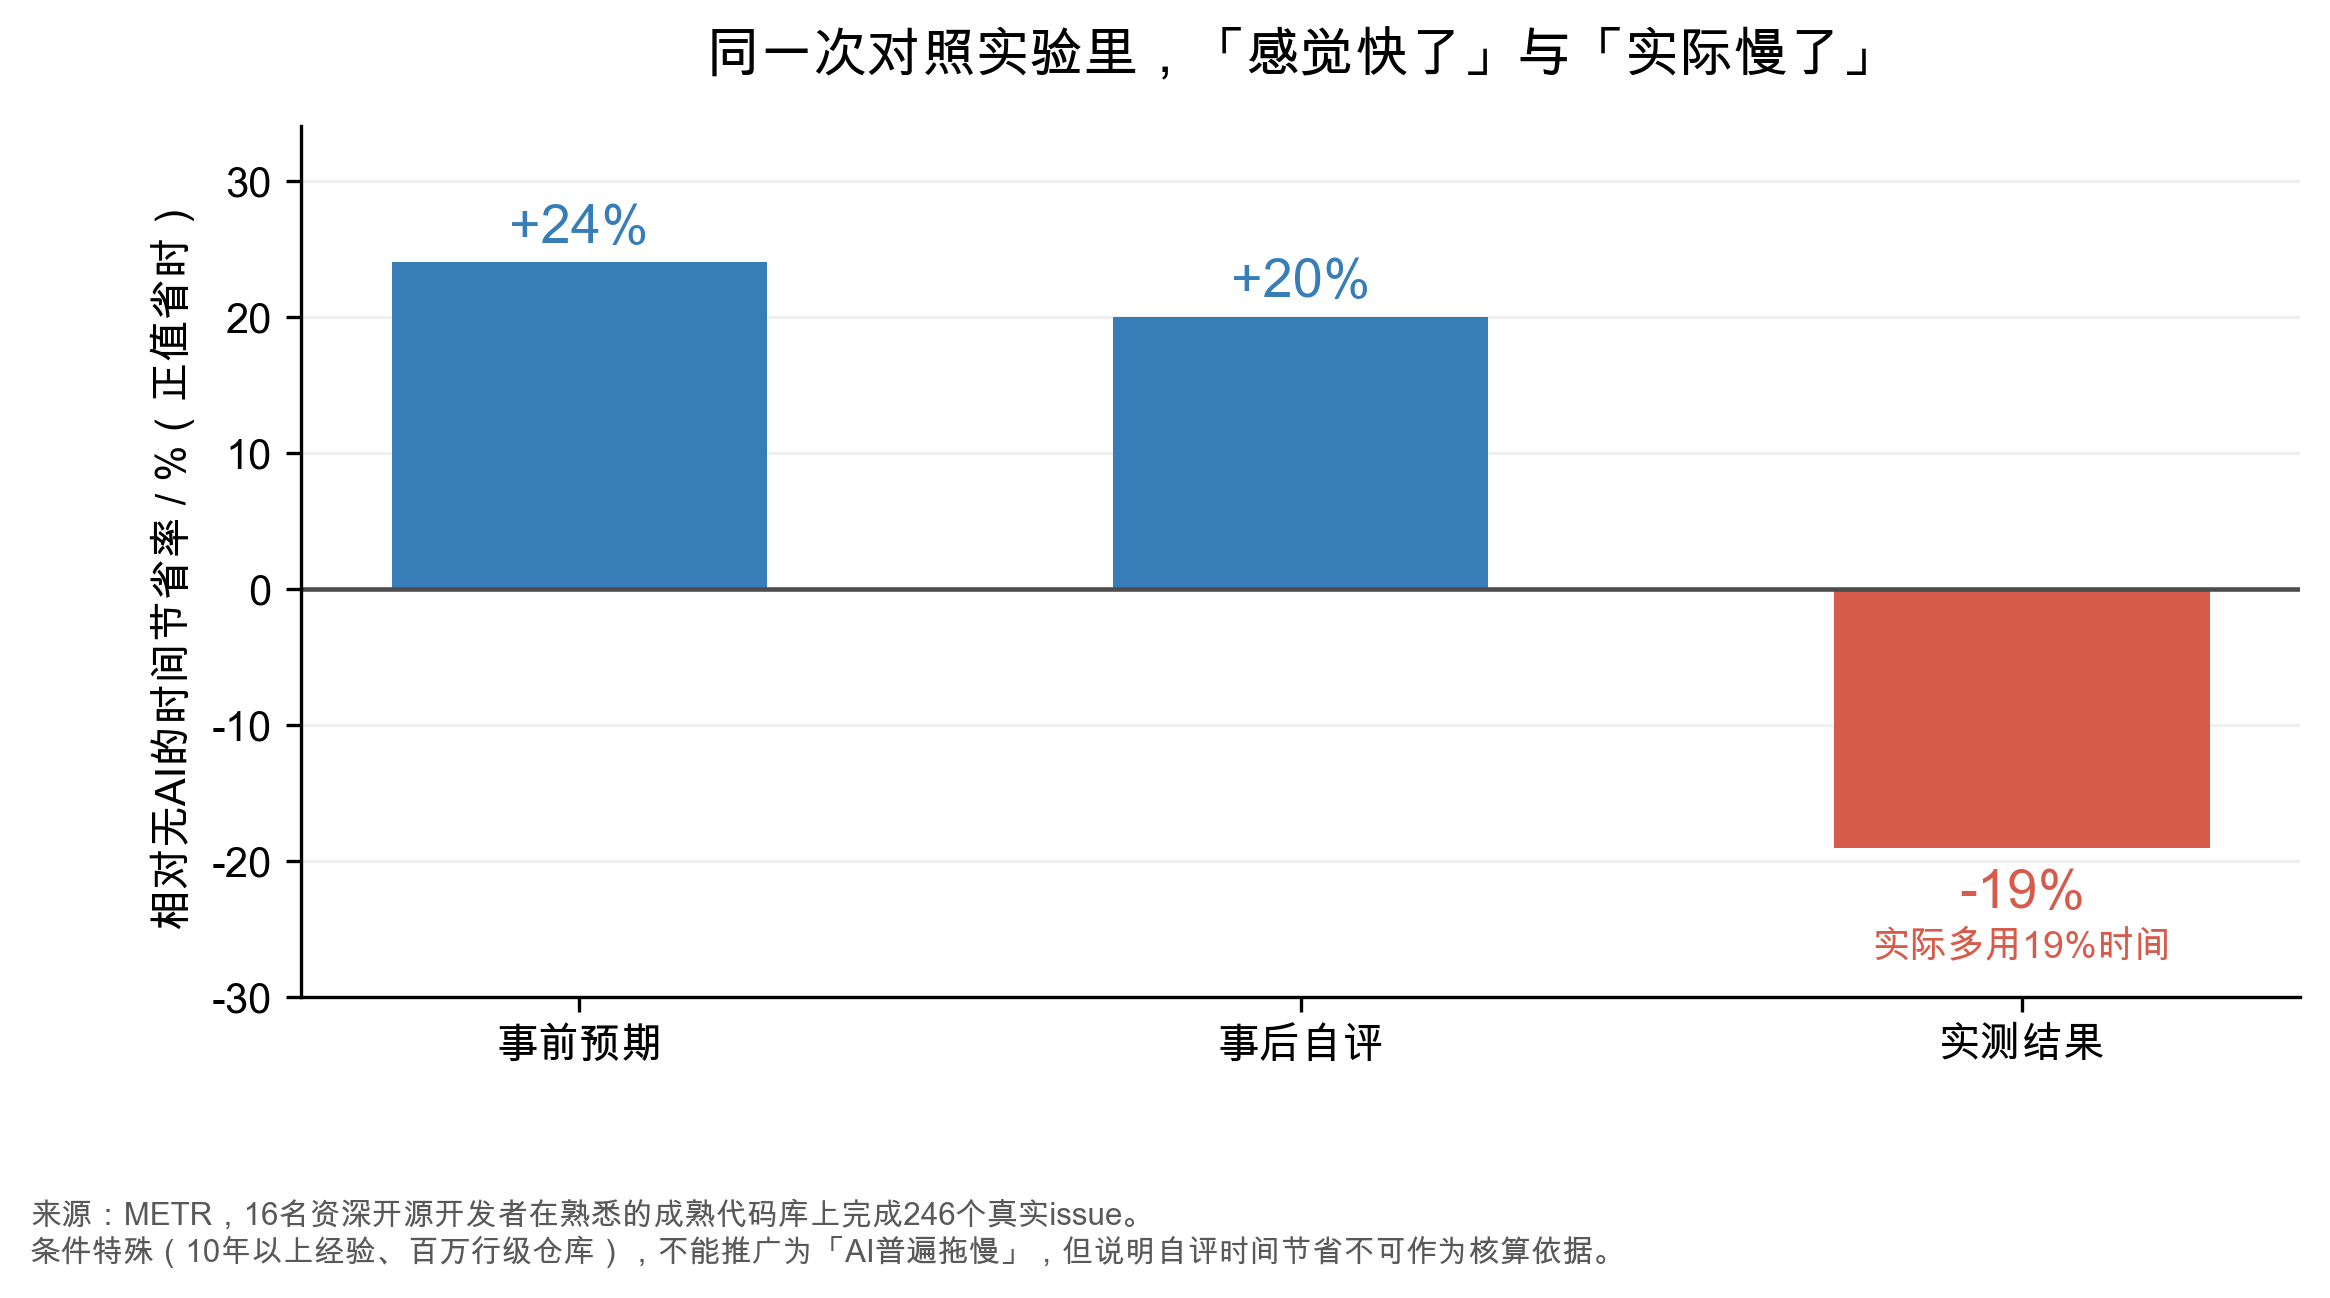
图7。同一批开发者、同一个对照实验里的三个数字。蓝色表示预期或自评的时间节省;红色表示实测多用19%的时间,纵轴统一为时间节省率。
第三,AI辅助硬件研发的公开证据基本是空白。 检索的结果很干脆:没有任何以人类工程师为被试、随机分组、测量完成时间的对照实验——板级调试、波形排查、嵌入式故障排查都是空白。 现有的人因对照全部在软件任务上(Copilot的对照实验把时间缩短55.8%,Google内部实验约21%),而这两项都不能挪用到硬件。Copilot RCT、Google
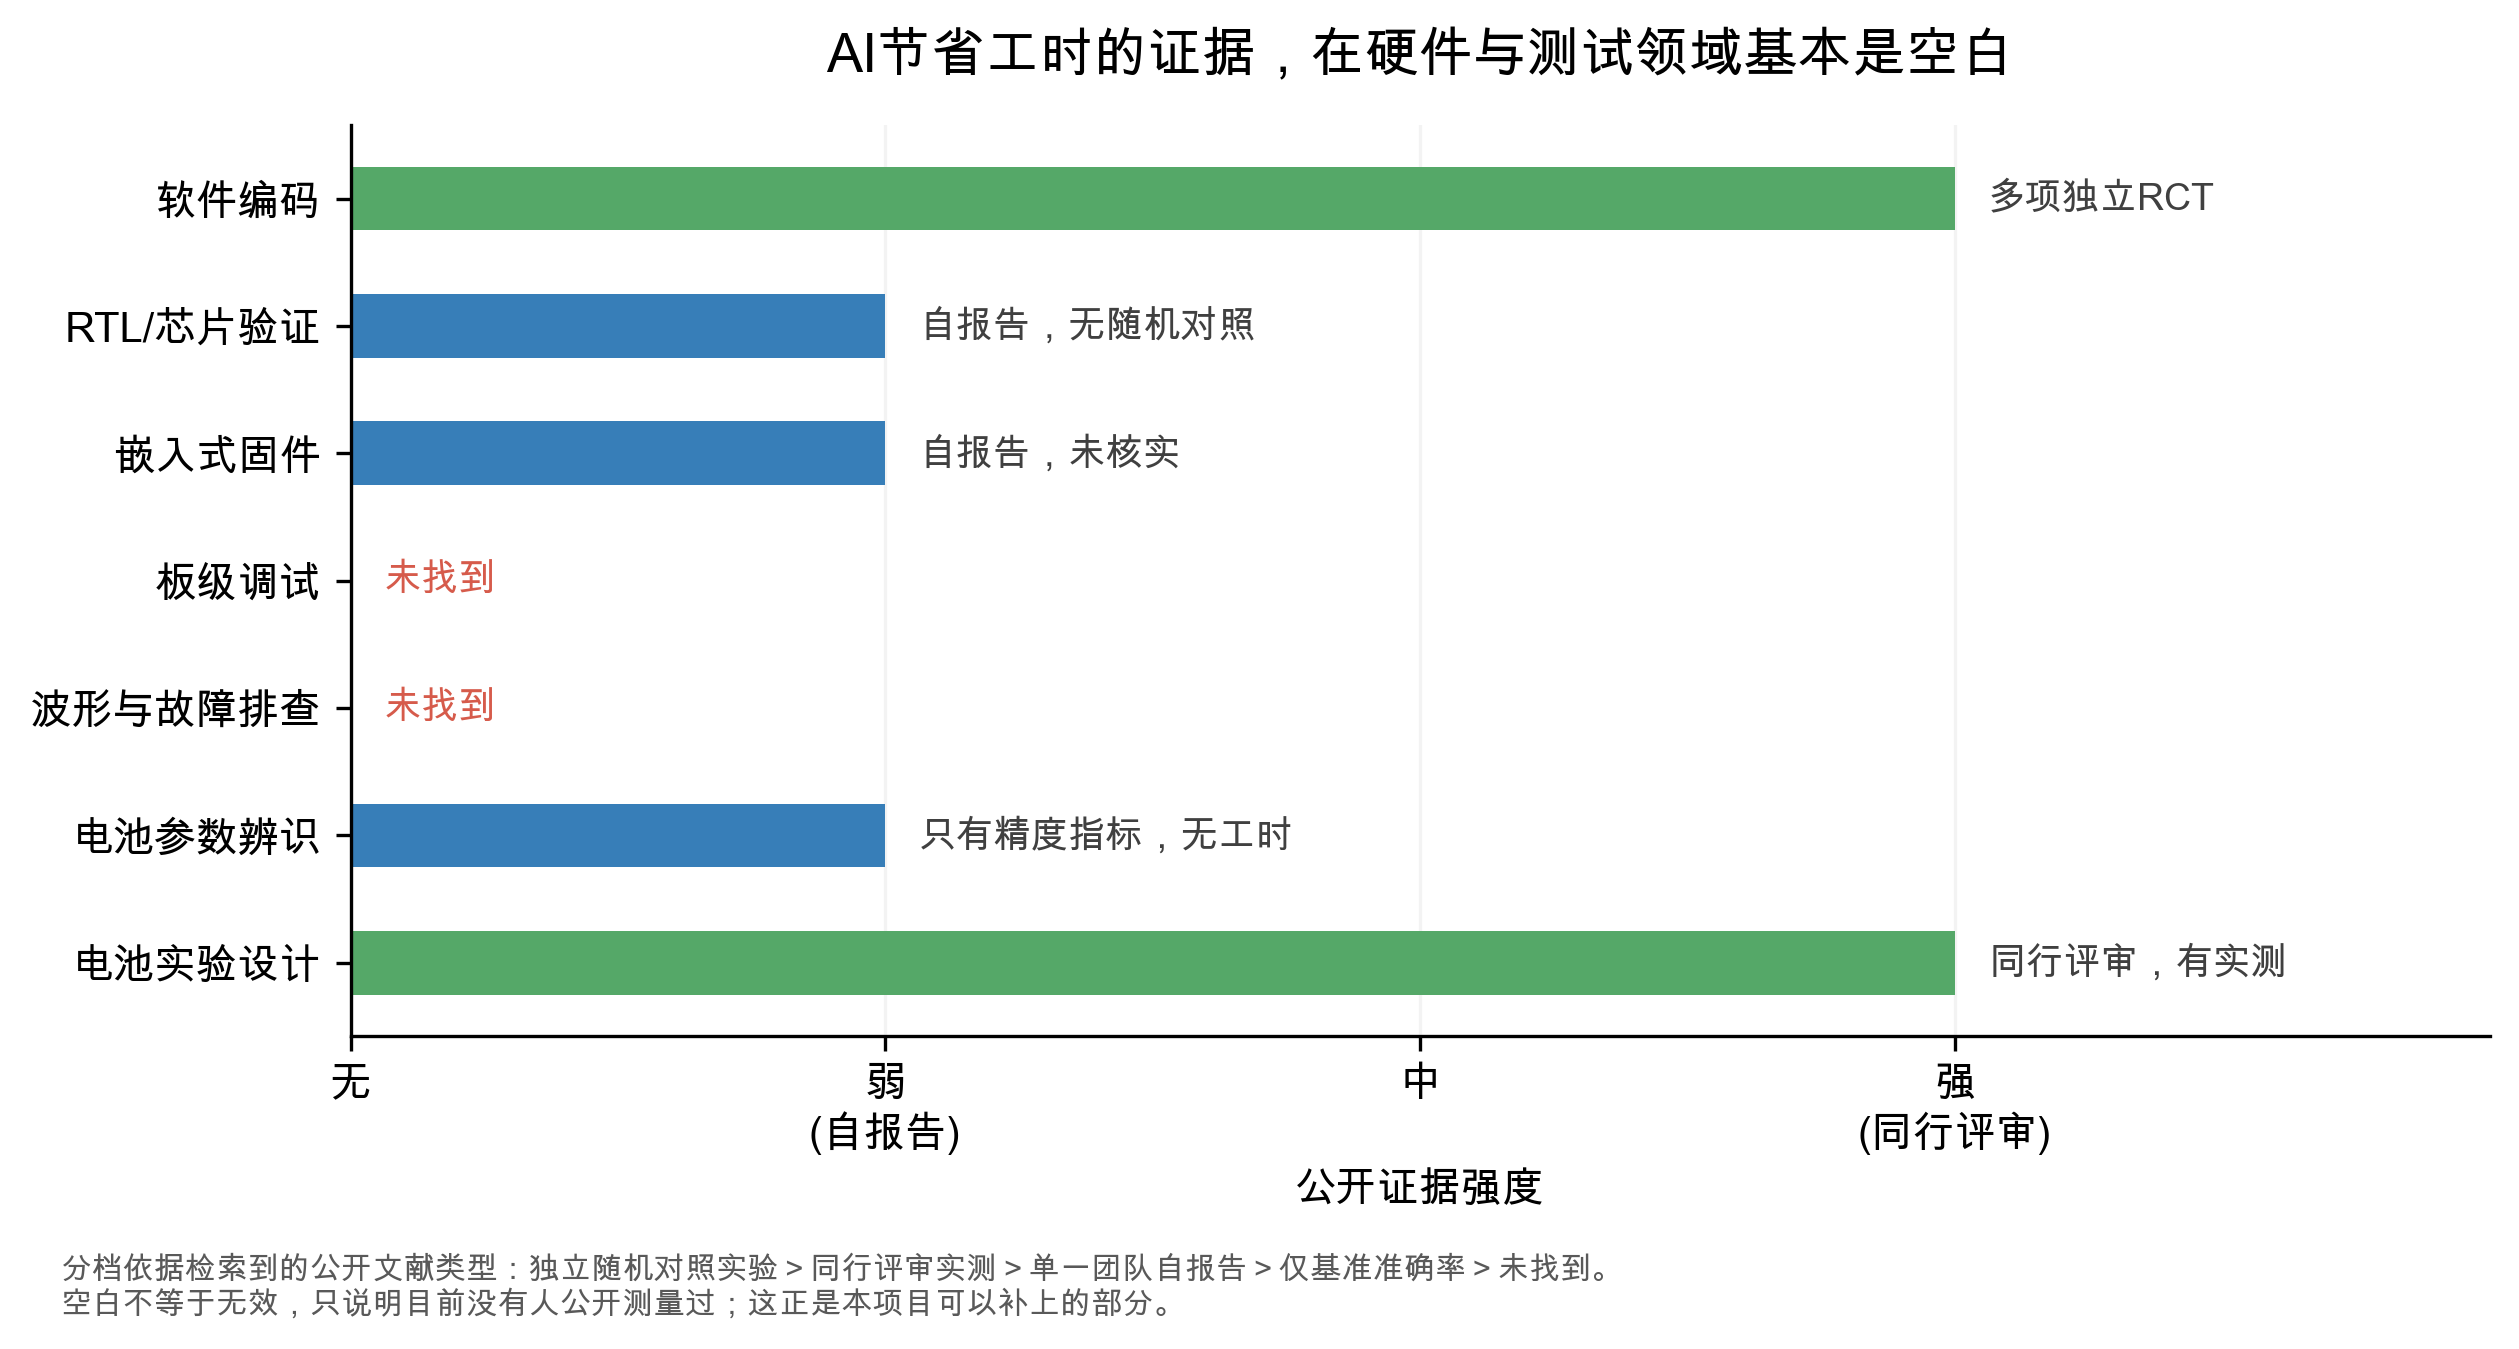
图8。分档依据公开文献类型。空白不等于无效,只说明目前没有人公开测量过——这恰好是本项目可以补上的部分。
七、还有一个衰减约束
如果AI的优势只是"想得更多",那它靠多调用就能弥补准确率。公开数据显示这条路走得慢。
MLE-bench上,GPT-4o把时间预算从24小时加到100小时(4倍),奖牌率只从8.7%升到11.8%——4倍资源换1.36倍成功率。 DSBench上人类基线准确率64.06%,最佳AI配置34.12%。MLE-bench、DSBench
这两条说明:便宜的推理换来的是"多试几次",不是"想得更准"。 对BMS的含义是——靠堆调用去猜参数会很快饱和;只有在工作本身是检索、比对、整理、生成变体、以及决定下一个实验做什么的时候,认知优势才兑现。这也再次指向第三节:有价值的是"选择",不是"重试"。
八、这对投资意味着什么
把上面合起来,判断是三句话:
- 实验量减少不等于研发费用同比减少,需要综合评定AI优化提效和AI使用成本。 第二节把同一个46%的实验量降幅代入两种费用情景,得到−8%与+41.68%的净可变成本节省率。成本比和新增调用次数决定实验减少后是否仍然省钱;BMS必须换成自己的账单。
- 物理测试的替代与缩短都需要同质量验证。 看的是达到同一验收要求所需的实验次数、工时和日历时间是否下降;调用增加本身不能计为收益。
- 阶段时长比不能直接当作可替代比例。 AVL公开流程给出数值标定约2周、完整BoL流程约6个月。按26周换算,2/26约为7.7%;这只比较两个时长尺度,不能据此认定其余92.3%不可改善,也不能把7.7%当成总工期节省上限。
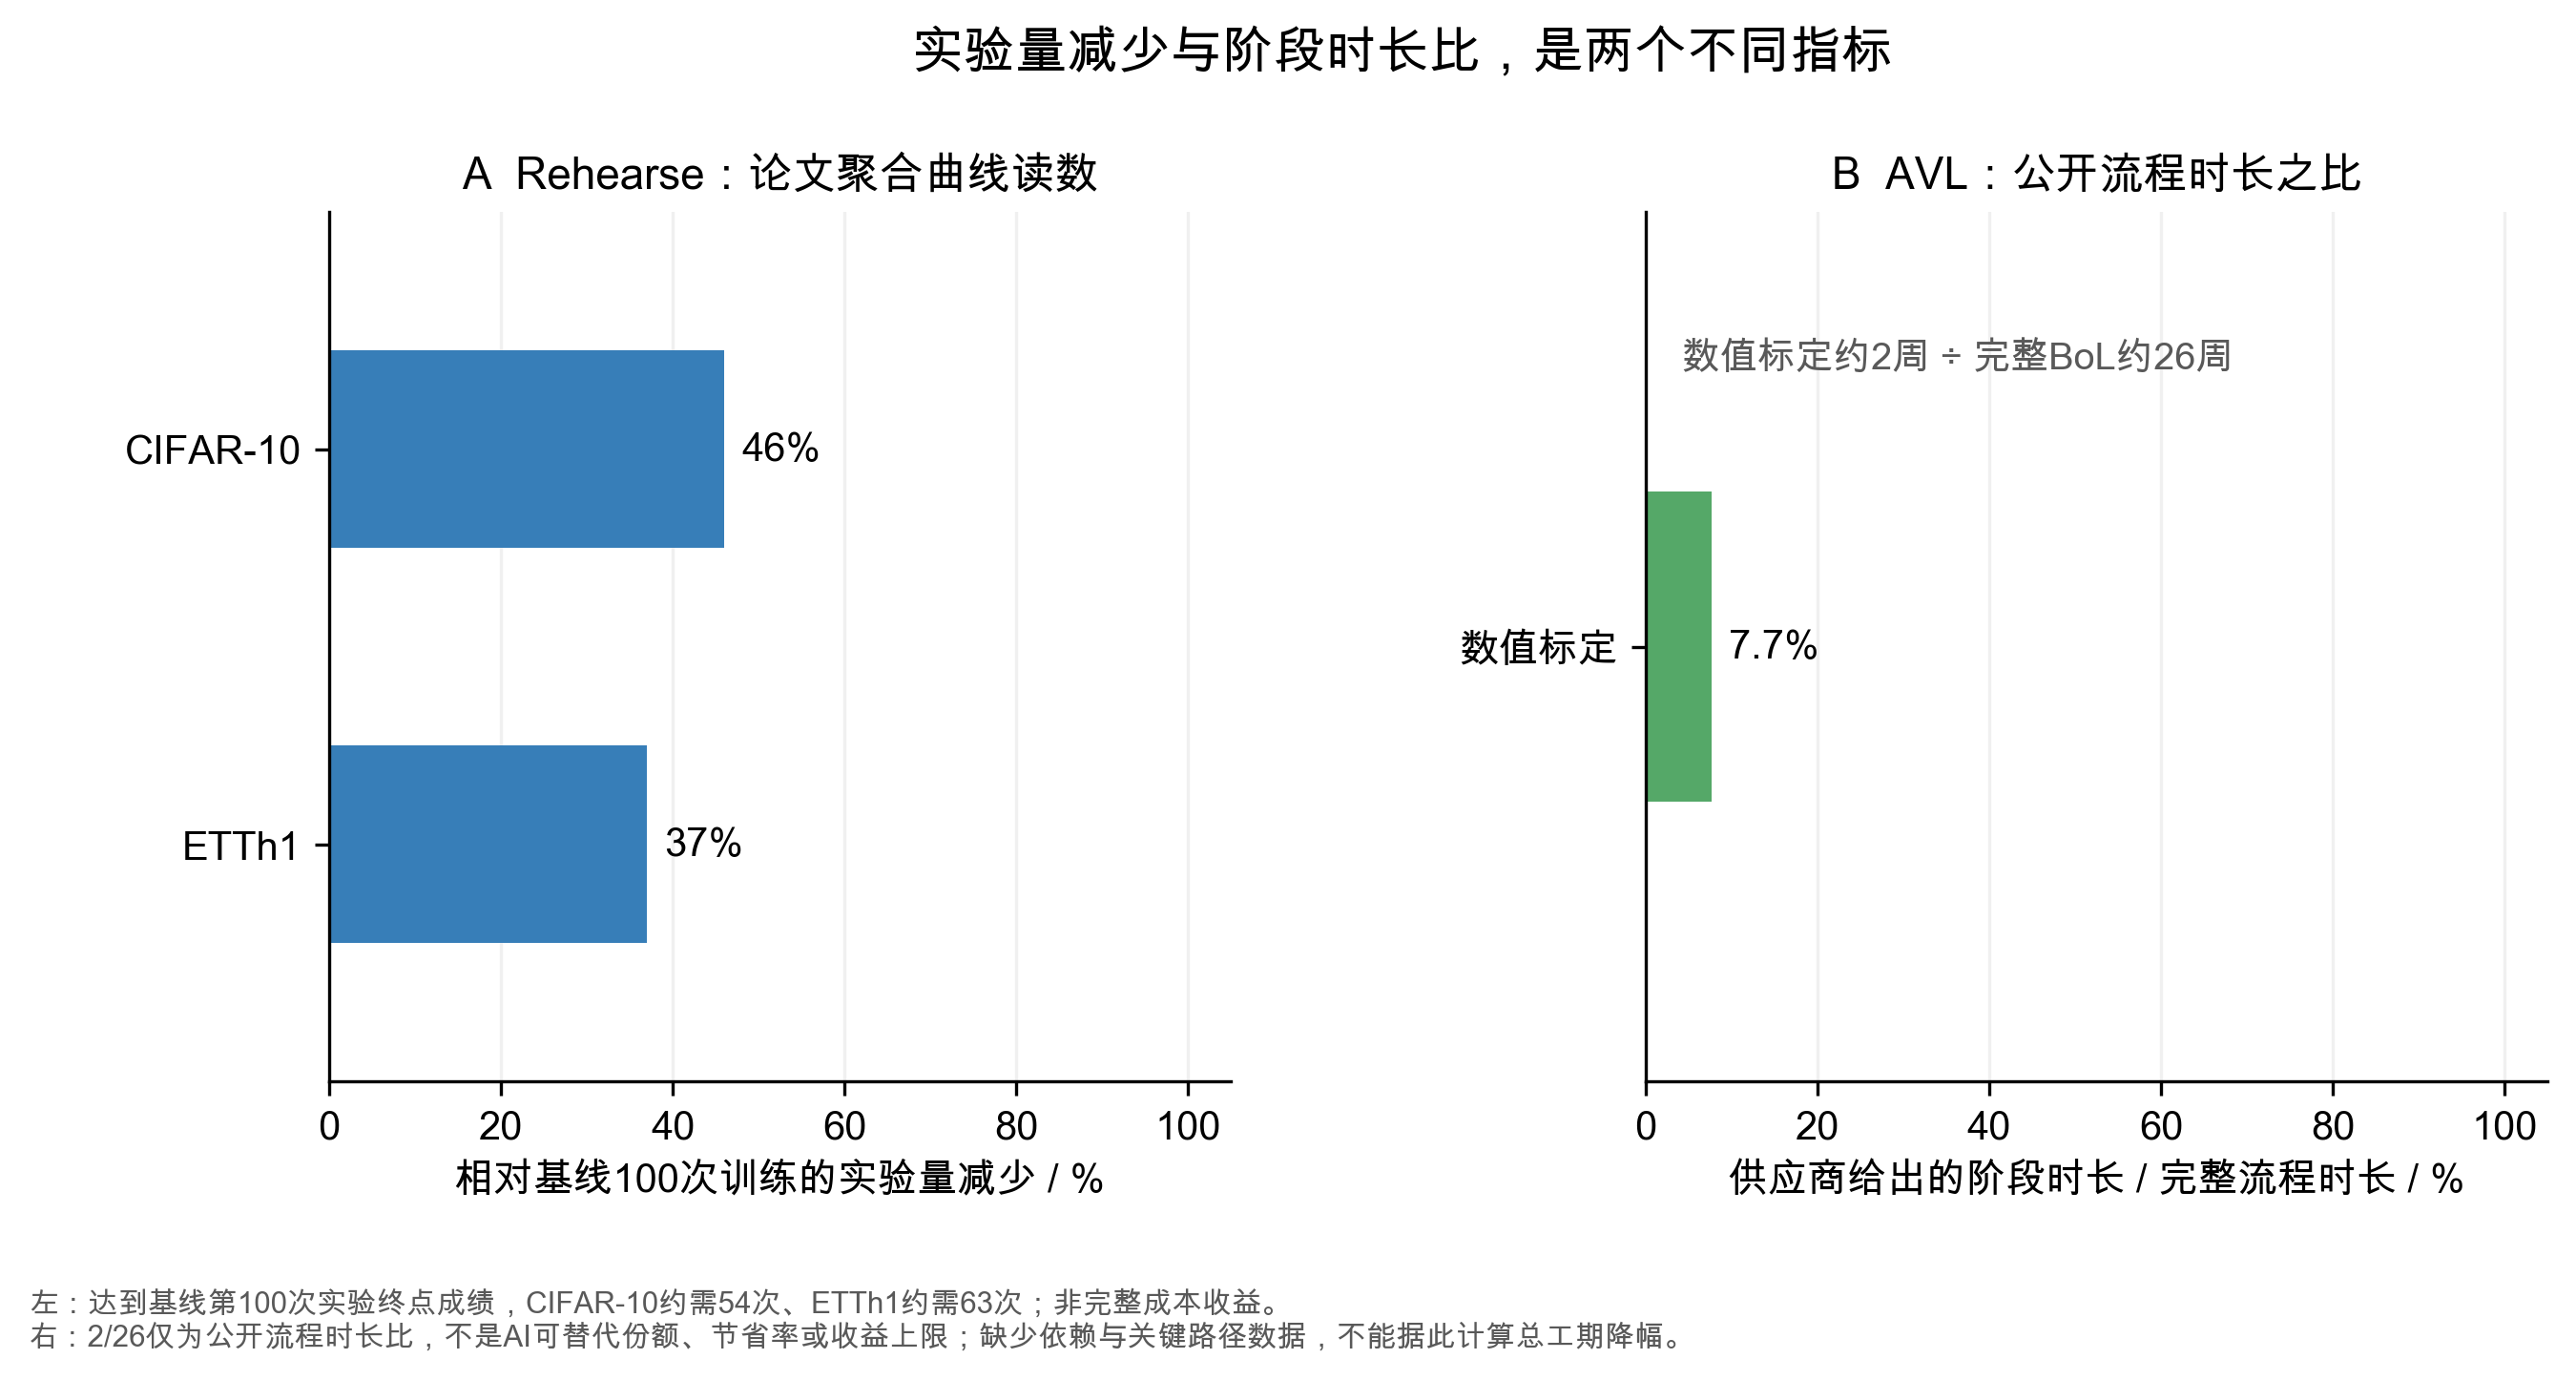
图9。两个面板分别展示训练实验量减少46%与数值标定阶段时长比约7.7%,分母不同,不可直接比较。后者不是已验证的可替代比例、节省率或收益上限;总工期变化还取决于阶段重叠及关键路径。
所以收益判断按这个顺序:
- 先记账。 一次实验的真实成本(物料、台架、工时)、一次调用的真实账单、一个环节的真实人时。
- 再标定可替代比例。 哪些环节真能被搜索改善,哪些受物理约束。这必须在自己的流程上测。
- 最后才谈规模。 先验证同质量任务的净节省,再检查它能复用到多少款新电芯,并扣除接入和维护投入。
对钠电BMS,我会先选参数辨识这一段,设三组对照:方法固定、能查看历史记录、能修改并保留自己方法的Agent,在未参与开发的新电芯上独立验收。主指标是固定预算下新任务的独立验收通过率,辅助指标是达到同一门槛所需的实验次数与工时。
第二节的公式在这里作为费用检查:记录基线实验费X、新增调用均价c和次数m,计算保本门槛;再用独立任务中达到同一验收要求的实验总次数,计算实际节省率s。若s低于门槛,优先减少评判调用或提高实验筛选有效性;若高于门槛,再检查人工复核与接入投入是否吃掉余量。若达标率或失败任务分布变差,应先修正研发方法,不能仅凭低费用保留它。
九、数据来源
电芯实验成本由公开挂牌价、公开招标单价与公开薪酬拼合,另有汇率与工时假设,不是任何企业的实际报价,也不是本项目实测。工程师费率由公开薪酬推导,不含实际企业人力成本。Attia的工作是磷酸铁锂快充协议搜索,与钠电BMS参数辨识不完全同类。"AI节省工程师工时"在硬件与测试领域的证据缺口,是本篇无法用公开数据补上的部分。 虚拟标定能替代多少实体测试,也没有找到可信公开数据。
参考资料
登录后可以留言
Peter YU2026/10/14 23:35:58
一篇很深厚并在他人研究基础上的高质量数学论证,在往议题方向的大胆假设与探索中。“RSI的节省率”是个有趣的指标,有点像大半个世纪前企业经营指标中的杜邦分析的思维,有利于对不同场景的AI实验室做取舍与人机分配的评估。