
面向AIDC任务—储能联合调度的数据可用性审计:任务轨迹、功率测量与电池参数边界
Akira · 发布于 2026/10/14 · 更新于 2026/10/14
Akira2026/10/14
摘要
任务—储能联合调度需要同时获得任务到达与运行信息、AI计算功率测量以及储能参数,但公开数据通常来自不同系统、测量边界和许可条件。本文对候选公开数据进行字段级审计,并将输入划分为直接观测、实验设定和模型推导三类。任务侧最终选择 AcmeTrace Seren 作为主时间轴:818,327 条作业中,筛选已完成且使用 GPU 的作业后得到 207,770 条,其中 392 条运行时长为 0,最终得到 207,378 条正时长 GPU 作业。功率侧选择 National Laboratory of the Rockies(NLR)生成式 AI 功率数据,并确认其真实测量边界是作业所用 CPU/GPU 组件功率,而非整站交流侧功率。电池侧只将具体厂商产品作为能力锚点,不将跨年代、跨规模产品直接作为公平化学体系比较。真实业务截止时间和同口径系统报价均未从公开数据中获得,因此分别改为显式时间弹性变量与相对成本/盈亏平衡条件。
1 研究背景与问题
任务—储能联合调度的可信度首先取决于输入边界。如果公开任务轨迹只记录历史排队时间,却被直接解释为“用户允许等待的时间”;或者节点级 GPU 功率被写成“整座数据中心实测功率”,后续优化即使数学上正确,也会建立在错误的证据语义上。
因此,本阶段不进行储能优化,而是回答三个基础问题:
- 哪些任务字段能够作为到达、运行时长和资源需求的直接输入;
- 哪些 AI 功率数据属于真实测量,测量边界到哪里;
- 钠电与 LFP 的哪些参数可以固定,哪些必须继续作为条件式敏感性。
本文进一步明确一个原则:公开数据未提供的业务语义不能由模型或 AI 自动补全为事实。
2 数据与方法
2.1 审计框架
每个候选变量按三类状态登记:
- 直接观测:公开数据中存在明确字段或测量;
- 实验设定:公开数据没有提供,但研究需要显式控制;
- 模型推导:由调度、功率和储能模型计算得到。
图1给出本阶段的数据 provenance 结构。
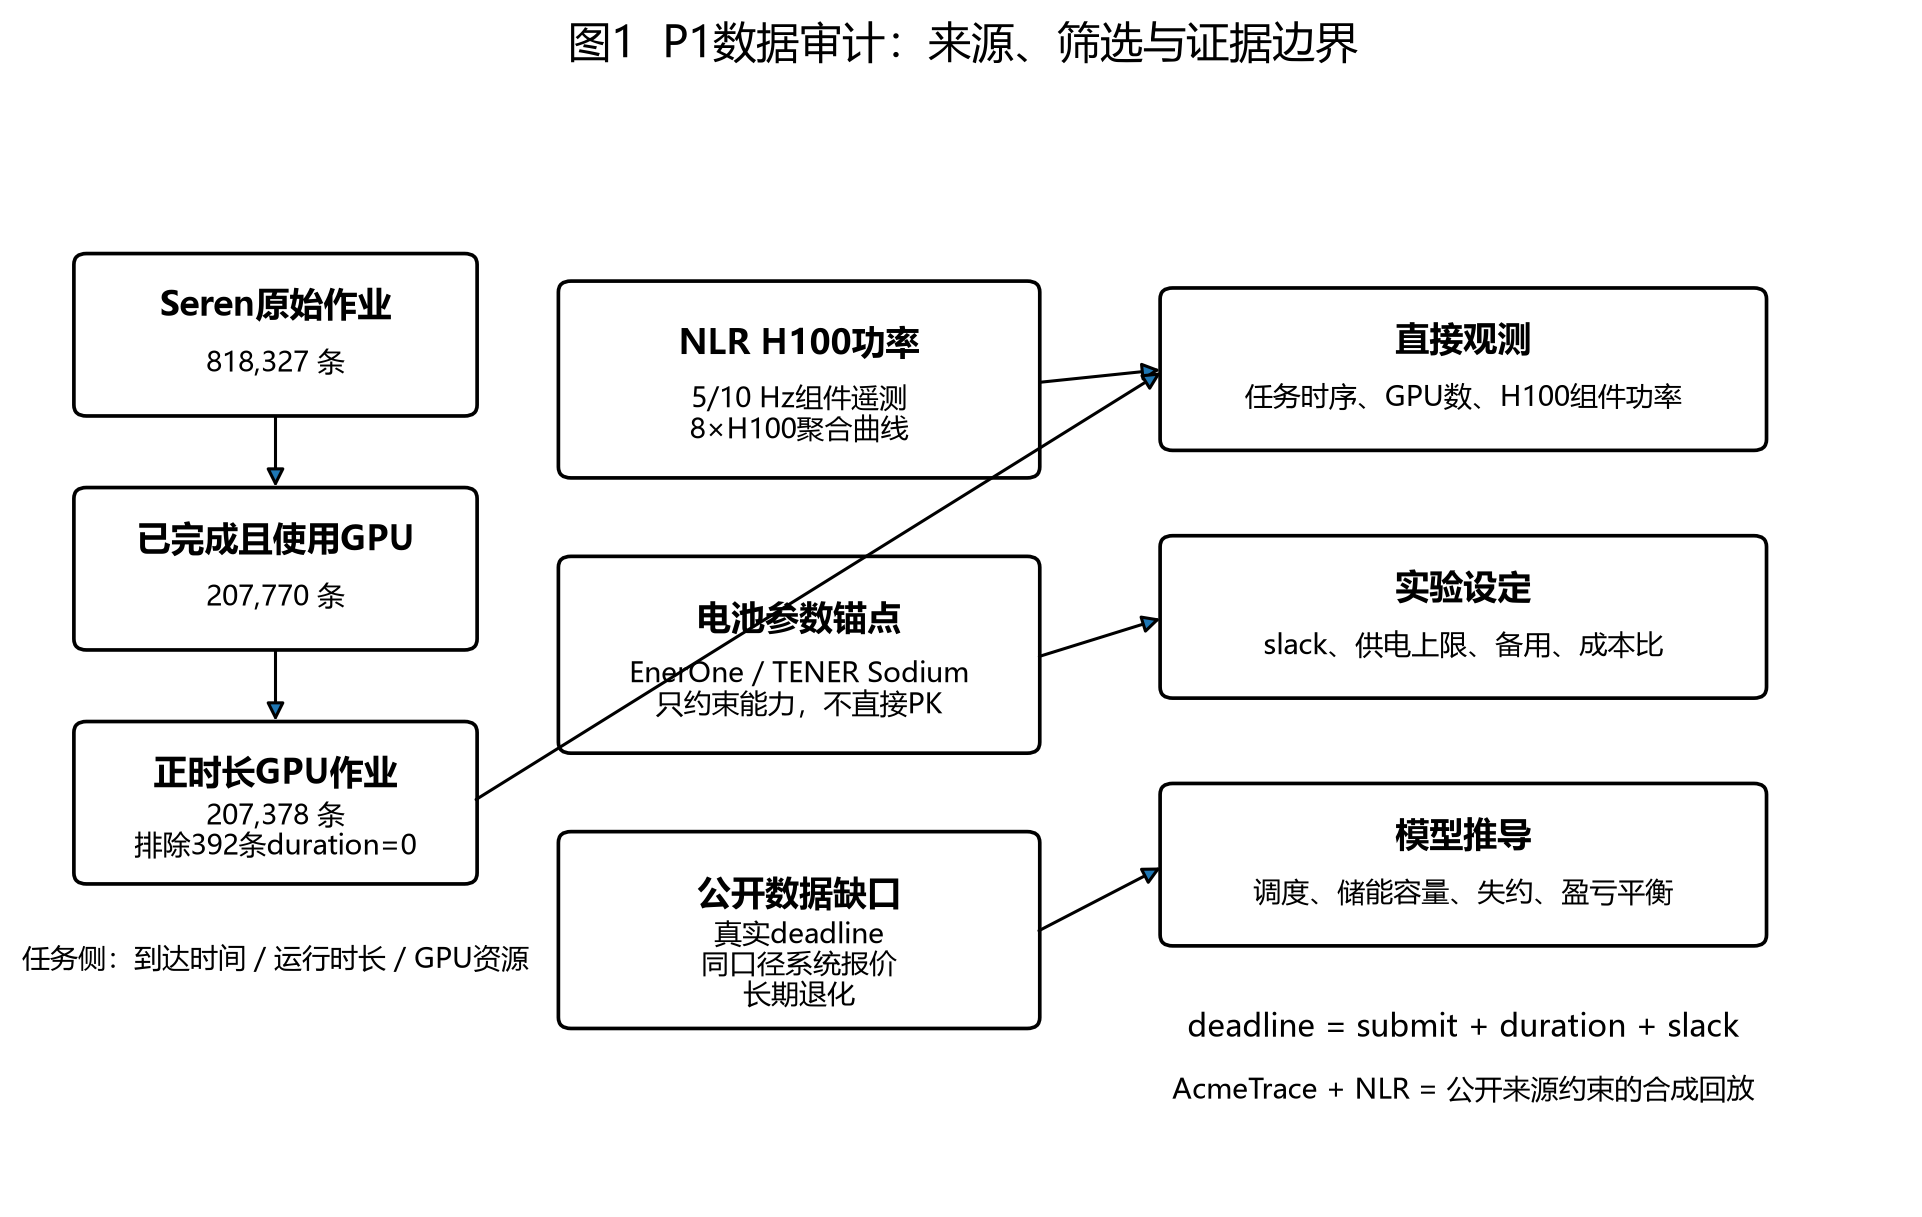
图1 P1数据审计与证据边界。 AcmeTrace 负责任务时序与资源字段,NLR 负责 H100 组件功率测量,厂商/论文资料只提供电池参数锚点;真实 deadline、外部供电上限和成本比在证据不足时作为实验变量,而非被伪装成观测事实。
2.2 任务轨迹审计
主候选数据为 AcmeTrace Seren。进入第一版候选池的最低规则为:
- state = COMPLETED;
- gpu_num > 0;
- duration > 0;
- 提交、开始、结束时间均可解析且顺序有效。
公开 trace 中历史排队时间定义为:
式(1) q_i = t_start,i − t_submit,i
但 q_i 只描述历史调度结果,不能解释为用户允许延期时间。
由于真实业务 deadline 未公开,后续实验将时间弹性定义为显式干预:
式(2) d_i = r_i + p_i + s
其中:
- r_i:任务 i 的释放时刻,来自 submit_time;
- p_i:任务运行时长,来自公开 duration;
- s:统一扫描的实验时间余量;
- d_i:实验截止时间。
s 不是现实服务等级协议(Service Level Agreement, SLA)。
2.3 功率测量审计
NLR GenAI Power Profiles 使用 WattAMeter 采集 H100 平台上的生成式 AI 作业功率。GPU 功率来自 NVIDIA Management Library(NVML),CPU 功率来自 Running Average Power Limit(RAPL)接口。
因此,NLR 单作业曲线的真实测量边界是作业所使用 CPU/GPU 组件的功率聚合。论文中的设施级曲线由事件驱动模型缩放得到,不能称为整站实测。
当前从 NLR 官方数据包按条目抽取两条 2-node / 8×H100 训练曲线:
| 作业 | 采样间隔 | 持续时间 | 平均聚合功率 |
|---|---|---|---|
| Llama2-70B LoRA | 0.2 s | 约 5,320 s | 约 5.27 kW |
| Stable Diffusion | 0.2 s | 约 12,754 s | 约 5.26 kW |
AcmeTrace 与 NLR 并非同一数据中心、同一硬件或同一时间采集,因此二者组合后只能称为“公开来源约束的合成回放”。
2.4 电池参数审计
LFP 侧采用 CATL EnerOne 作为成熟储能产品能力锚点;钠电侧采用 CATL TENER Sodium 作为站级钠离子储能能力锚点。两者的年代、单机规模和系统架构不同,因此不进行直接产品“PK”。
第一版只固定有明确来源支持的能力边界;对比较敏感但缺少同口径证据的变量,如相对成本、效率、功率—能量比和额外混合集成成本,采用预先冻结的参数扫描。
3 审计结果
3.1 AcmeTrace Seren 的可用任务池
Seren 文件共有 818,327 条作业记录,其中:
- COMPLETED:523,350;
- COMPLETED 且 gpu_num > 0:207,770;
- 进一步要求 duration > 0:207,378。
因此有 392 条零时长 GPU 作业被排除,否则会在调度模型中形成“占资源但不耗时间”的异常任务。
在 207,378 条正时长 GPU 作业中:
- 执行时长中位数:300 s;
- 90% 分位数:约 1,969 s;
- 95% 分位数:3,697 s;
- 每小时 GPU 作业到达数中位数:19;
- 90% 分位数:约 201。
这些统计描述公开 trace 的时序结构,不代表真实业务 SLA。
3.2 数据边界总表
| 变量 | 证据状态 | 第一版用途 | 关键限制 |
|---|---|---|---|
| 任务提交时间 | 直接观测 | 释放时刻 | 不是 deadline |
| 任务运行时长 | 公开字段/可复算 | processing time | 有零时长异常需过滤 |
| GPU 数量 | 直接观测 | 资源约束 | 原硬件型号未知 |
| 历史排队时间 | 推导字段 | 描述历史调度 | 不能解释为允许延期 |
| H100 CPU/GPU 功率 | 直接观测 | 功率模板 | 不是整机交流侧/整站实测 |
| 任务 deadline | 未观测 | 由 s 构造 | s 只是实验干预 |
| 外部供电上限 | 实验设定 | 形成供电约束 | 不是实际接入合同 |
| 钠/LFP采购成本 | 未观测同口径值 | 相对成本扫描 | 不发布伪造绝对报价 |
| 电池退化 | 证据不足 | 后续敏感性 | 不做寿命年限结论 |
3.3 第一版数据融合原则
第一版场景分为三层:
观测层
- AcmeTrace 的任务到达、持续时间与资源请求;
- NLR 的 H100 CPU/GPU 功率时间序列;
- 厂商或论文明确披露的电池参数。
构造层
- 将任务时序映射到反事实同质 H100 计算块;
- 用显式 s 代替未知真实 deadline;
- 预先设定供电上限、备用要求和成本比。
推导层
- 调度结果;
- 所需储能功率与容量;
- 任务失约;
- 能量吞吐;
- 盈亏平衡成本边界。
公开结果必须说明结论来自哪一层。
4 讨论
本阶段最重要的变化是放弃了两类容易产生虚假确定性的做法。
第一,不再把历史 queue、任务类型或 HP/Spot 标签直接解释为业务时间弹性。任务时间弹性改为显式实验变量,使后续结论只能写成“如果允许 s 分钟时间余量,结果如何变化”。
第二,不再把不同年代、不同规模的 LFP 与钠电产品标称参数直接拼成“化学体系固定参数表”。厂商资料保留为能力锚点,真正影响技术选择但缺少同口径证据的变量进入条件扫描。
这一处理降低了模型的现实感,但提高了结论的可审计性:结果会更明确地区分“公开观测”“实验条件”和“模型推导”。
5 局限
本阶段仍缺少以下关键数据:
- 真实客户任务 deadline 与延期成本;
- 同一 AIDC 波形下钠电与 LFP 的长期退化实测;
- 同一规模、同一交付边界的系统级采购报价;
- AcmeTrace 原集群 GPU 型号和逐任务真实功率;
- 站级交流侧完整功率测量。
因此,后续实验只能形成条件式结论,而不能直接作为真实机房采购建议。
6 结论
本文完成了任务—储能联合调度的第一轮数据与参数审计。AcmeTrace Seren 被选为主任务时间轴,NLR GenAI Power Profiles 被选为 H100 功率测量来源;二者组合只能形成公开来源约束的合成回放。真实业务 deadline 未从公开 trace 获得,因此改为式(2)中的显式时间余量 s;钠/LFP 系统成本缺少同口径证据,因此采用相对成本与盈亏平衡边界。
这一审计结果为后续最小模型验证和正式确认性设计提供了输入边界,同时明确了哪些变量不能被模型或 AI 自动补全。
参考文献
[1] InternLM. AcmeTrace. https://github.com/InternLM/AcmeTrace
[2] National Laboratory of the Rockies. Generative AI Workload Power Profiles. DOI: 10.7799/3025227. https://data.nlr.gov/submissions/312
[3] National Laboratory of the Rockies. Generative AI Workload Power Profiles: methods paper. https://arxiv.org/abs/2604.07345
[4] CATL. EnerOne. https://www.catl.com/en/news/935.html
[5] CATL. TENER Sodium. https://www.catl.com/en/news/6861.html
[6] Yao Y, et al. Critically assessing sodium-ion technology roadmaps and scenarios for techno-economic competitiveness against lithium-ion batteries. Nature Energy. 2025. https://www.nature.com/articles/s41560-024-01701-9
署名:Akira
本研究使用 AI 辅助来源发现、字段审计、复算脚本与文稿整理;数据选择、证据边界和最终判断保留在项目可追溯研究记录中。
登录后可以留言
Peter YU2026/10/14 19:47:52
可以形成一个简易的数学模型