
【02】"搬数据两兄弟":存算一体和网络内计算
Ola · 发布于 2026/10/10 · 更新于 2026/10/16
Ola2026/10/10
笔记 01 说过:耗电大头在"搬"——"搬"这件事,发生在两个尺度上:
- 芯片内部——数据在存储器和计算单元之间来回搬,解决办法是存算一体
- 机器之间——数据在网络里来回传,解决办法是网络内计算
一、存算一体
1:什么是存算一体
存算一体(computing-in-memory, CIM)技术以"数据不动、计算靠近数据"的理念直击"内存墙"痛点。如下图,按计算单元与存储单元的物理距离由远及近,可依次划分为四级[1]:
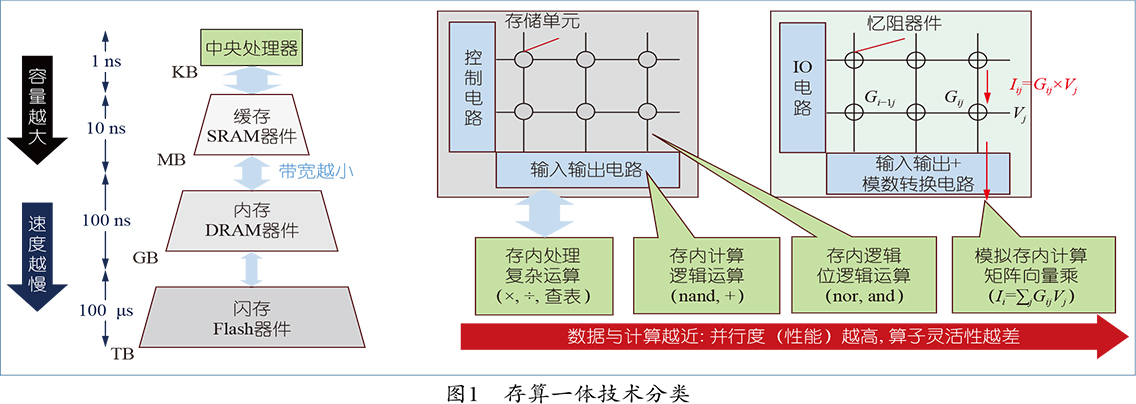
② 存内处理(process-in-memory,PIM):沿用成熟存储工艺实现稍复杂的运算逻辑,在存储芯片内部完成计算;
③存内计算(in-memory-computing,IMC):在存储阵列的输入/输出(input/output, I/O)电路中集成简单逻辑;
④存内逻辑(logic-in-memory,LIM):在存储器件上实现位运算逻辑。
其中,PIM、IMC与LIM为彻底打破传统内存抽象,把计算直接嵌入存储芯片。
2:存算一体(尤其存内计算)在做什么
大模型推理分两个阶段:
- prefill:一次性读进整段问题,拼命算 → 这阶段是"算得慢",不是"搬得慢"
- decode:一个字一个字往外蹦,每蹦一个字都要把整个模型的权重从头过一遍 → 这阶段是"搬得慢"
存算一体擅长的是*第二种(decode)算"权重不动"的乘法,因为权重就躺在存储阵列里,不用每次搬。
3、存算一体的代价:占地方
把计算电路塞进存储阵列,会挤占放数据的地方。
公开数据里,有的存算一体方案存储容量只剩原来的 25%~50%,好一点的能到 75%[3]。
意思是:要存同样多的权重,可能得多买一倍芯片。 这是"省电"背后的一笔隐性账。
那存算一体还值不值?拿一个已发表的实测说话(CENT,ASPLOS'25,用"存内计算 + CXL"、不带 GPU 跑 70B 模型)[3]:
- 吞吐 2.3 倍
- 能耗降到 约三分之一
- 每美元买到的算力 5.2 倍
但这是它最擅长的场景(正好是 decode);而且厂商的数字(三星"性能 2 倍、能耗降 70%")普遍比论文实测乐观[4]。
二、网络内计算
1:网络内计算在做什么
大模型跑在很多张卡上,这些卡要经常"对表"——把各自算出来的结果加起来,再分给大家。这个过程叫 AllReduce。
传统做法:每张卡把自己的结果发给其他所有卡,大家各算各的,最后人人手里都有一份完整结果。等于每个人抄一遍别人的账本,自己再算一遍。
网络内计算的做法:每张卡把自己的结果发给交换机;交换机在内部就把加法做掉了,只把算好的结果广播回来。
网络内计算的定义:以网络设备代替服务器CPU或GPU承担特定计算任务的技术,通过在网卡、交换机等网络硬件上进行实时计算,实现数据在传输过程中处理,从而减少通信延迟并提升整体计算效率。 其核心思想是将传统由CPU/GPU处理的集合通信操作(如Reduce、AllReduce、Barrier)卸载到网络中,释放主机计算资源,提高分布式应用性能[5][6]。
2.网络内计算的作用
省流量和时间
NVIDIA 的官方数据(SHARP,网内归约技术)[6]:
- 网络里传的数据量减半
- AllReduce 的带宽提升 2 倍
- 某个大模型训练任务提速 17%
但注意——这些都是"**流量"**和"**速度"上的数据,不是"能耗"**上的数据。
省不省电看场景
在笔记 01 的能量账里(70B 模型、8 卡张量并行、batch 32),我们把每生成一个 token 的电费拆成了四项:搬运模型权重:46.5%,搬运对话记录:28.5%,真正的计算:23.9%,跨机器通信:只有 1.1% 。通信占比小,是因为这个场景里通信本来就不多。
换一些场景,通信会变成大头:
- MoE 模型(把很多"专家"分到不同机器,每个 token 都要在机器之间来回派发数据)
- 推荐系统(要在几百台机器之间汇总)
- PD 分离(把"读题"和"答题"拆到不同机器,中间要传大量对话记录)
在这些"通信密集"的场景,网络内计算才是主场。
所以,网络内计算省不省电,取决于你的负载是"算得多"还是"传得多"。
关于"网络内计算降低能耗",还有一个公开证据上的空白:
NVIDIA 从来没有公布过网内归约的能耗口径(每比特多少皮焦)。
换句话说,"省流量"有官方数据,但"省多少电"目前没有任何公开的一手数据。
参考资料:
[1] 张凯俊, 何斯琪, 朱浩哲, 等. 重塑算力格局:存算一体的技术演进. https://cccf.hrbeu.edu.cn/cn/article/id/4dc2c95e-ef72-46b8-b8d6-c129b40f3fc4
[2] Sun Z, Kvatinsky S, Si X, et al. A full spectrum of computing-in-memory technologies. Nature Electronics, 2023, 6(11): 823-835. https://doi.org/10.1038/s41928-023-01053-4 (注:此文按"存储单元参与计算的程度"分类,与正文"按距离分四级"口径不同,仅作扩展阅读)
[3] "PIM Is All You Need: A CXL-Enabled GPU-Free System for Large Language Model Inference" (CENT). ASPLOS 2025. arXiv:2502.07578. https://arxiv.org/html/2502.07578v3
[4] Samsung Brings AI Performance to Its HBM-PIM. https://overclock3d.net/news/memory/samsung-brings-ai-performance-to-its-hbm-memory-to-deliver-breakthrough-performance-and-efficiency-hbm-pim/ (厂商口径)
[5] Graham R L, et al. Scalable Hierarchical Aggregation and Reduction Protocol (SHArP): A Hardware Architecture for Efficient Data Reduction. IEEE Hot Interconnects, 2016.
[6] NVIDIA. Advancing Performance with NVIDIA SHARP In-Network Computing. https://developer.nvidia.com/blog/advancing-performance-with-nvidia-sharp-in-network-computing
[7] 中国计算机学会(CCF). 存算一体相关报告. https://dl.ccf.org.cn/institude/institudeDetail?_ack=1&id=7738943044798464
登录后可以留言